模型下线倒计时:写死的模型名怎么查、换完贵多少
11/30 盘古 2.0 与 DeepSeek-V4.1-Flash 下线,12/14 Copilot 再退六个。官方给了替换名单,却没给能力与价格差异:一条丢了前缀续写,一条白天账单涨 3.2 倍。这篇给一套能跑的查名与比差方法。
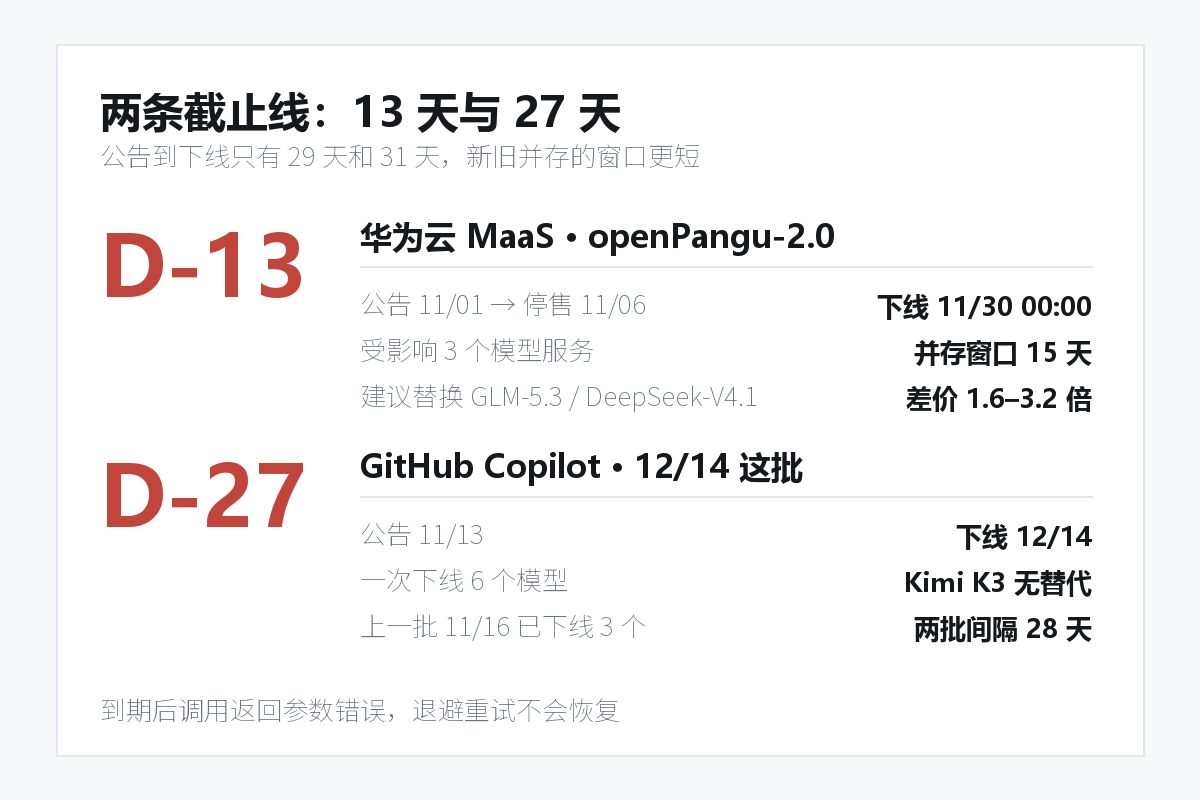
11 月 30 日零点,华为云把 openPangu-2.0-Flash、2.0-Pro 和 DeepSeek-V4.1-Flash 一起下线;12 月 14 日,GitHub Copilot 再退六个模型。
两份公告都写了"建议替换",但都没写替换之后少什么能力、贵多少钱。这两件事,得自己算。
官方给了替换名单,没给差异清单
华为云 11 月 1 日的公告很短:openPangu-2.0-Flash 与 2.0-Pro 于 11 月 6 日停止销售,11 月 30 日 0 点下线,下线后新老用户都不能调用。
建议替换也写得干脆——Flash 换 DeepSeek-V4.1-Flash-1017,Pro 换 GLM-5.3。
同一份公告里有一行小字,转述时几乎都被跳过:不同模型在支持能力、API 参数、单价和实际任务表现上存在差异,迁移前需读模型介绍并做必要评测。翻成普通话就是:换哪个替你定了,换完会少什么、贵多少,你自己查。
先说 Pro 这条线。2.0-Pro 支持前缀续写,深度思考可开关,512K 上下文、最大输出 128K、TPM 100 万。换成 GLM-5.3 之后,上下文涨到 1M、TPM 涨到 200 万,但有两项变了:前缀续写不在支持列表里,深度思考变成不可关闭。
前缀续写不是冷门功能。强制 JSON 首字符、让模型接着写半句话、把表格头塞回去让它续行,用的都是它。迁移之后这类请求要么报参数错误,要么被静默忽略——不同 SDK 的行为并不一致,而"模型更强了"这句话里没有任何线索。
深度思考不可关闭听起来不像坏事,实际是成本结构变了。原来简单分类任务可以关掉思维链,只付几十个输出 token;关不掉以后,每次请求都要先生成一段推理,输出量按量级往上走。
输出 token 为什么会放大,这篇拆过两个放大器,思维链正是其中之一。
再看钱。官方计费页给得很细,斜杠前后分别是单次请求 32K 以内与以上的两档价。
| 项目 | 2.0-Pro → GLM-5.3 |
|---|---|
| 输入价(元/百万) | 3.2 / 4.8 → 8 |
| 输入价倍数 | 2.5 / 1.7 倍 |
| 输出价 | 14.5 / 17.6 → 28 |
| 输出价倍数 | 1.9 / 1.6 倍 |
| 缓存命中价 | 0.8 / 1.2 → 2 |
| 计价档位 | 32K 分档 → 单一价 |
| 前缀续写 | 支持 → 不支持 |
| 深度思考 | 可开关 → 不可关闭 |
Flash 那条线长得不一样。DeepSeek-V4.1-Flash-1017 把上下文从 512K 提到 1M、最大输出从 128K 提到 384K、TPM 从 100 万提到 200 万,还多了图像理解,能力项没有一项变少。看上去是一次纯升级。
但账单不是。按"月输入 3 亿 tokens、输出 0.6 亿 tokens"这个中等规模算,比值 5:1,接近多数问答类应用:
| 路径与倍数 | 账单变化 |
|---|---|
| Flash → DeepSeek,白天(3.2 倍) | 336 → 1080 元 |
| Flash → DeepSeek,夜间(1.6 倍) | 336 → 540 元 |
| Pro → GLM-5.3,同流量(2.2 倍) | 1830 → 4080 元 |
同样是迁移,白天跑和夜里跑的涨幅差一倍。原因在计价口径:DeepSeek 这条引入了忙闲时差价,08:00–20:59 一个价,21:00–07:59 打对折,缓存命中价从 0.2 降到 0.1。而 openPangu 2.0 两条都是单一价,不区分时段。
所以"迁完贵多少"没有统一答案,得先知道你的流量落在哪个时段。白天为主的批处理,输出价从 1.6 涨到 8,五倍;夜里为主的离线任务,涨 2.5 倍。同一份公告,两种结局。
模型选型到这里才算完整:一半是能力够不够,一半是账单扛不扛得住。
这里要划清一条界:以上只比规格和价格,我没有实测替换后的回答质量。能力项以官方模型列表为准,官方对 GLM-5.3 的编程与 agent 能力有更强表述,那部分不进本文的账。
一个版本能活多久:中位 204 天,最短 81 天
华为云的模型名带版本号:openpangu-2.0-flash 是 20260630,openpangu-2.0-pro 是 20260730。这个数字就是上架日期。配上公告里的下线日期,每个版本在架上待了多久可以算出来。
把公告里能对上号的 14 个样本算完:最短 81 天,中位 204 天,最长 486 天。
最短的那个是 DeepSeek-V4.1-Flash,版本 20260910,9 月 10 日上架,11 月 30 日下线。它的替代品叫 DeepSeek-V4.1-Flash-1017——同一个名字,加了个日期后缀。
这带来第一个坑,而且很具体:deepseek-v4.1-flash 是 deepseek-v4.1-flash-1017 的前缀。
如果配置里做前缀匹配、模糊匹配、"自动取最新版",两个名字会被当成同一个;如果监控按模型名前缀聚合,切换当天指标名下没有任何变化,图上一条直线,故障发生在你看不见的维度里。
我自己先踩了一次。给扫描脚本标注真值时按子串匹配,33 处里有 1 处把 -1017 认成了旧版,而这恰好是唯一一个"新版替代旧版"的样本。机器都这样,手工改配置时更容易。
第二个坑是大小写。官方模型列表里,2.1 写 openPangu-2.1-Pro,2.0 写全小写 openpangu-2.0-pro,而不少教程的调用参数写 openpangu-2.1-pro。
同一个模型,三种写法并存。这类字符串进代码前只有一个正确做法:从控制台原样复制,不要手打,也不要"顺手统一格式"。
Copilot 那边的节奏更紧。10 月 15 日公告,11 月 16 日下线 3 个(Opus 4.8、Opus 5、GPT-5.6 Terra);11 月 13 日再公告,12 月 14 日下线 6 个(Fable 5、Haiku 4.5、Gemini 3.8 Flash、Gemini 4 Argon、Grok 4.6、Kimi K3)。
两批间隔 28 天,预告期都是 31 到 32 天。
最值得看的不是数量,是 Kimi K3 那一栏:建议替代写的是 To be announced。官方在公告里直接承认"还没有替代品"。这一条把"厂商总会给你等价替代"的假设打破了。
另外两个例外决定谁需要动手:Haiku 4.5 与 Opus 4.8 对年付个人订阅仍然可用;Business 与 Enterprise 在默认设置下会自动启用替代模型,除非管理员关过全局默认。
只看模型清单,很容易把"不用管"和"必须改"的人搞反。
对程序来说结论只有一句:选择器里少几个选项是人的事,代码里写死的模型名到点就是硬失败。
三个命令找出仓库里所有写死的模型名
模型名藏得比想象中散,散在业务代码、配置和开发工具链的各个角落。按出现频率排,主要是四处:
- 业务代码里的字面量,
"model": "..."直接写在请求体里 - 配置与环境变量,.env、yaml、启动脚本、容器编排
- 提示词与文档,有人把"你运行在 X 上"写进 system prompt
- CI、评测集、前端下拉,最容易被忘——前端会把旧模型列表缓存到构建产物里
先放一个反直觉的数字:只写正则,抓不全。
我在一份 13 个文件、172 行的构造仓库上试了三种策略:
- 厂商前缀加紧邻版本号(gpt-4、qwen3- 这类):召回 19%,精度 55%。openpangu 不在里面,claude-opus-5 也不在。
- 厂商前缀加任意后缀:召回 69%,但把 claude-code、gemini-cli、llama-index 一起抓进来,精度 79%。
- 已知清单加切段判断:召回 100%,精度 97%。
前两种是在精度和召回之间二选一。第三种把"这是不是一个模型名"从模式判断换成查表,正则只负责兜底清单里没有的新模型。
import re

TOKEN = re.compile(r"[A-Za-z][A-Za-z0-9]*(?:[._/-][A-Za-z0-9]+)+")
STEMS = ("gpt", "claude", "gemini", "glm", "deepseek", "qwen", "kimi", "pangu")
TOOLS = {"claude-code", "gemini-cli", "llama-index", "deepseek-harness"}

def normalize(s):
    return s.strip().lower().replace("_", "-")

def is_model_like(tok):
    t = normalize(tok)
    if t in TOOLS or not any(c.isdigit() for c in t):
        return False
    segs = [s for s in re.split(r"[._/-]+", t) if s]
    # 必须切段比较:Graphics、isomorphic 里都含 phi,sqlite3_step 里含 step
    return len(segs) >= 2 and any(
        seg == stem or seg.startswith(stem) or seg.endswith(stem)
        for seg in segs for stem in STEMS
    )
关键在两处:切段,和兜底。
切段是因为厂商名会撞日常词。Graphics 里有 phi,isomorphic 里有 phi,yi_US 里有 yi,sqlite3_step 里有 step。
第一版我用子串判断,在 2,736 个真实文件上报了 11 处误报,全是这一类;改成按 . _ - / 切段后降到 6 处,再把 step 从词根表里删掉才归零。
兜底是为了抓新模型。清单是死的,模型是新的。凡是"切段里有厂商标识、整体含数字"的,进待确认,人工看一眼,不要直接当成模型名写进工单。
python modeleol.py scan ./src --today 2026-11-17文件 13 个,跳过超长行 0 行
命中模型名 32 处,涉及 14 个模型;其中 11 个有下线日期
[已下线 1 天] claude-opus-5(2 种写法) 共 2 处 → 建议 claude-opus-5-5
[剩 13 天] openPangu-2.0-Pro 共 6 处 → 建议 glm-5.3
app/chat.py:4
config/llm.yaml:15
[剩 27 天] kimi-k3 共 3 处 → 建议 (无指定替代)同一份脚本在 Python 3.13 标准库上跑:2,736 个文件,0 命中、0 待确认。这个对照说明误报主要来自判据写得太宽,不是仓库太脏——先把自己的规则收紧,比给结果打标签更管用。
换之前比差,换之后盯三个信号
找到名字只是第一步,换的时候还得知道换的是什么。同一张表既能查到期日,也能做两两对比。
$ python modeleol.py diff openpangu-2.0-pro glm-5.3

能力
  失去:前缀续写、深度思考可开关
长度与限流
  上下文:512K → 1024K  ↑
  最大输出:128K → 128K
  TPM:1,000,000 → 2,000,000  ↑
价格(元/百万 tokens)
  输入:3.20–4.80 → 8
  输出:14.50–17.60 → 28
月度账单(输入 300 亿、输出 60 亿 tokens)
  迁移前 1,830 元  →  迁移后 4,080 元   涨 2.23 倍
三段输出对应三类风险:能力项消失、限流与长度变化、价格与计价口径变化。第二段最容易被误读——TPM 从 100 万涨到 200 万,看着是扩容,但如果你同期把并发也翻倍,余量等于没动。限流要按"峰值 token 除以限额"看,不看绝对值。
换完上线,三个信号要单独拉出来:
- 4xx 里的模型相关错误,单独计数。它和 429 是两类:429 是容量问题,退避重试有用;模型不存在是配置问题,重试一万次也一样。混在一个"AI 调用失败率"里,你会以为是流量涨了。
- 每请求输出 token 的中位数。深度思考关不掉、或替代模型默认开思维链,这个数会跳。它比总量更早暴露问题,因为总量还会被流量波动掩盖。
- 峰值 TPM 占限额的比例。限额涨了不等于余量变大,替代模型更啰嗦时,token 涨得比限额快。
最后一个动作成本最低、收益最大:把模型名换成别名。
# config/llm.yaml
default:
  alias: llm.default
  model: deepseek-v4.1-flash-1017
  fallback: glm-5.3
fast:
  alias: llm.fast
  model: openpangu-2.1-pro
代码里只认 llm.default、llm.fast 这类逻辑名,真实模型 ID 放配置。下次公告出来,改的是一行配置,不是全仓库搜索替换。这顺带解决了前端缓存旧列表、评测集写死模型这类边角问题——它们都应该指向同一个配置源。
关于成本,还有一句容易误读的官方表述:内容生成成功计费,失败不计费。所以模型下线那一刻账单不会暴涨,暴涨的是失败率和重试队列。别把"没多花钱"当成"没事"。
如果你想的是干脆不再被单一厂商的排期牵着走,自建是另一条路,但卡数和三年成本在这里算过,未必更便宜;而在托管方案内部做端点级比价,可以看这篇里的 34 倍价差。
如果只做三件事
- 今天把 11/30 和 12/14 写进日历,各提前一周设提醒。公告到下线只有 29 到 32 天,比多数团队的发布周期短。
- 跑一次扫描,把"有下线日期"的条目按剩余天数排序。先改 D-13 那批,D-27 那批留到下次发版一起动。
- 动手前跑一次 diff,把能力项和账单两项写进变更单。能力项消失要在代码里改调用方式,账单变化要提前通知业务方——这两件事都不是运维一个人能签的。
模型名是少数"写下去就开始倒计时"的依赖,所以在企业AI项目里它不该散落在代码中。它不像证书那样会在浏览器里报警,只会在某个零点之后,让一次调用返回参数错误。
登录后可点赞、收藏与反馈。