#部署
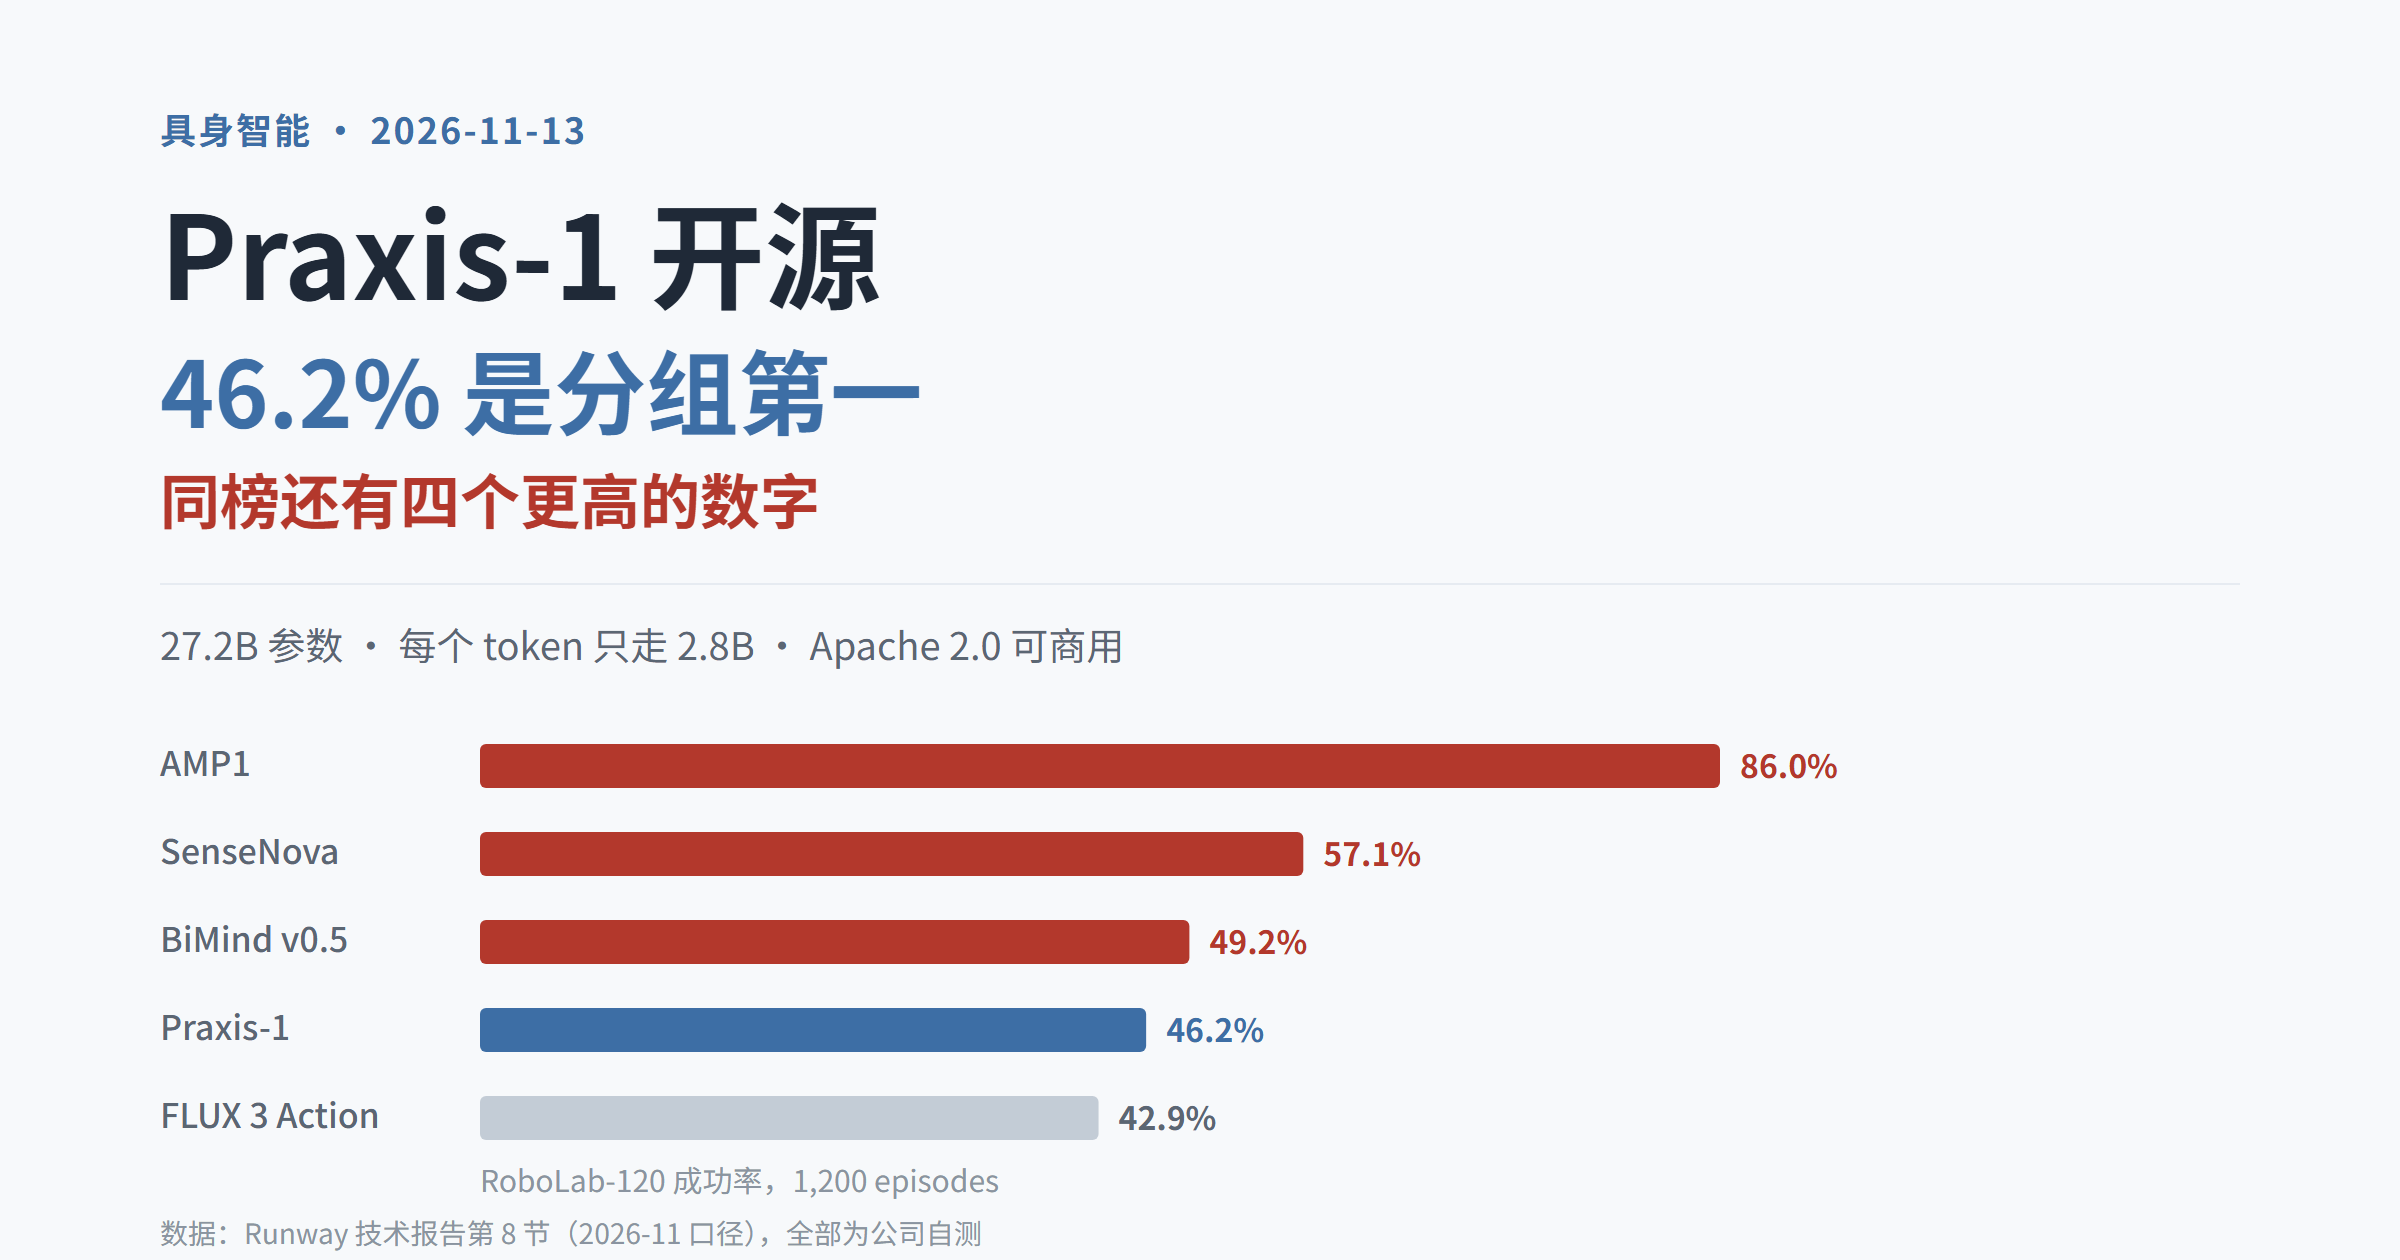
Praxis-1 开源:46.2% 是分组第一,同榜四个更高
Runway 把 27B 世界动作模型 Praxis-1 按 Apache 2.0 放出,官方称 RoboLab-120 双料第一。定语成立,但同一张表上还有 4 个更高的数字,最高 86%。本文拆开 27.2B 里活跃的 2.8B、1.6 秒一块的延迟账,以及中训练第 5 个点不涨的原因。
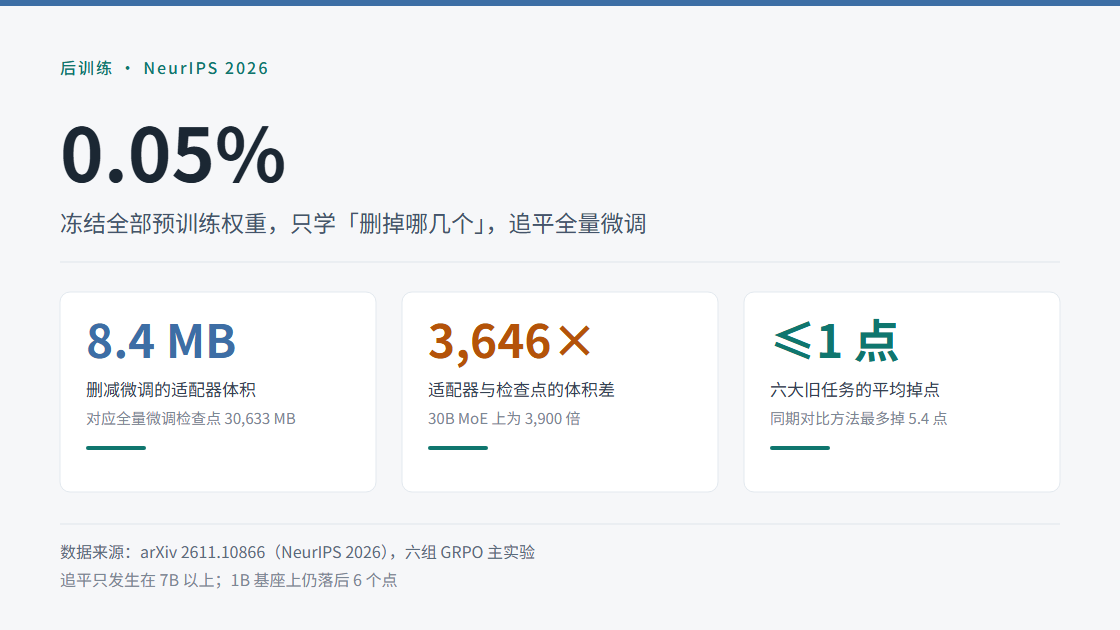
删掉 0.05% 权重追平全量微调,适配器只剩 8.4MB
NeurIPS 2026 的 Deletion Tuning 冻结全部预训练权重,只把不到 0.05% 的权重置零,在 8 个基座上追平全量微调。本文拆开机制、7B 门槛与三处不能照抄的地方。
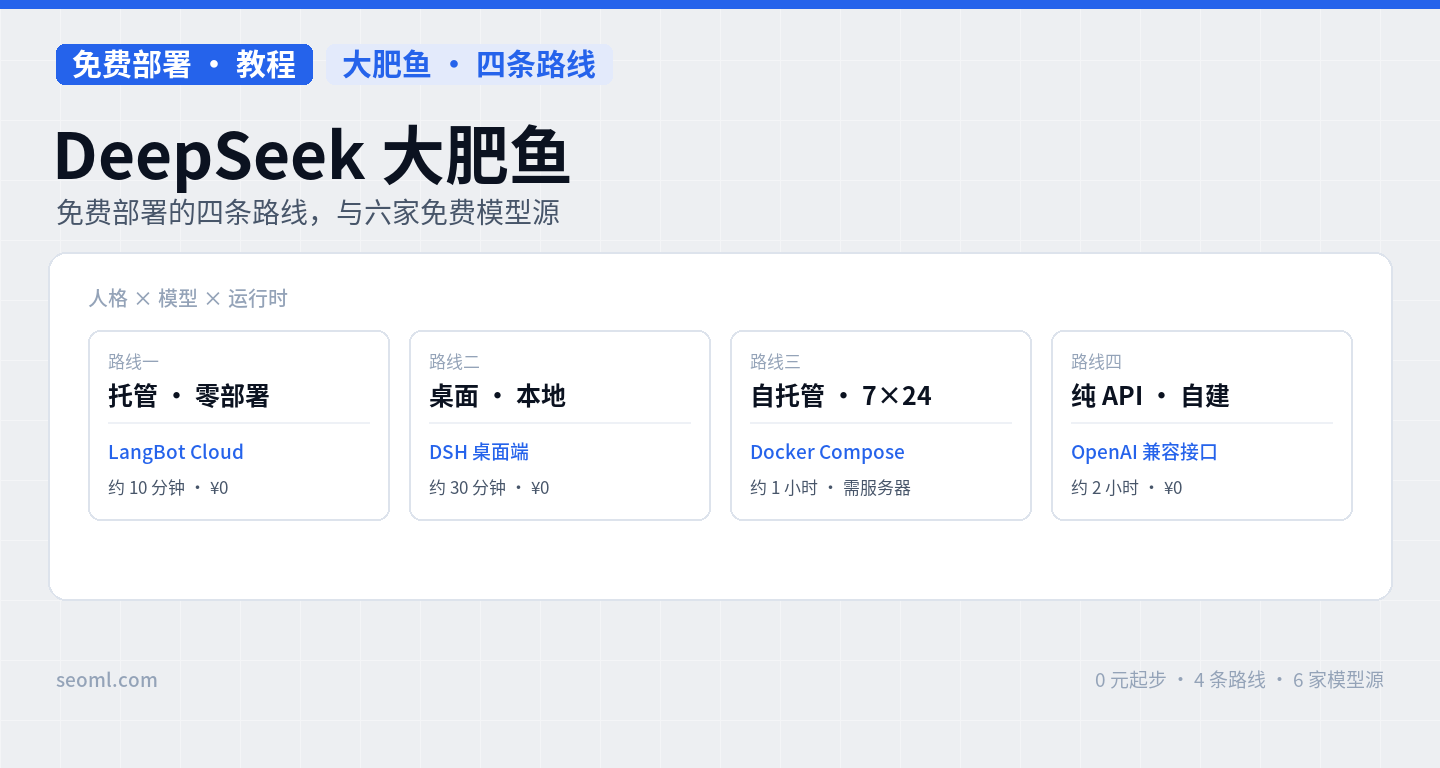
DeepSeek 大肥鱼免费部署:4 条路线与 6 家模型源
大肥鱼是社区给 DeepSeek 做的拟人角色,跑起来要三样东西:人格提示词、常驻运行时、模型供给。本文给 4 条部署路线与 6 家免费模型源,逐条标出上手时间、成本与断线风险。
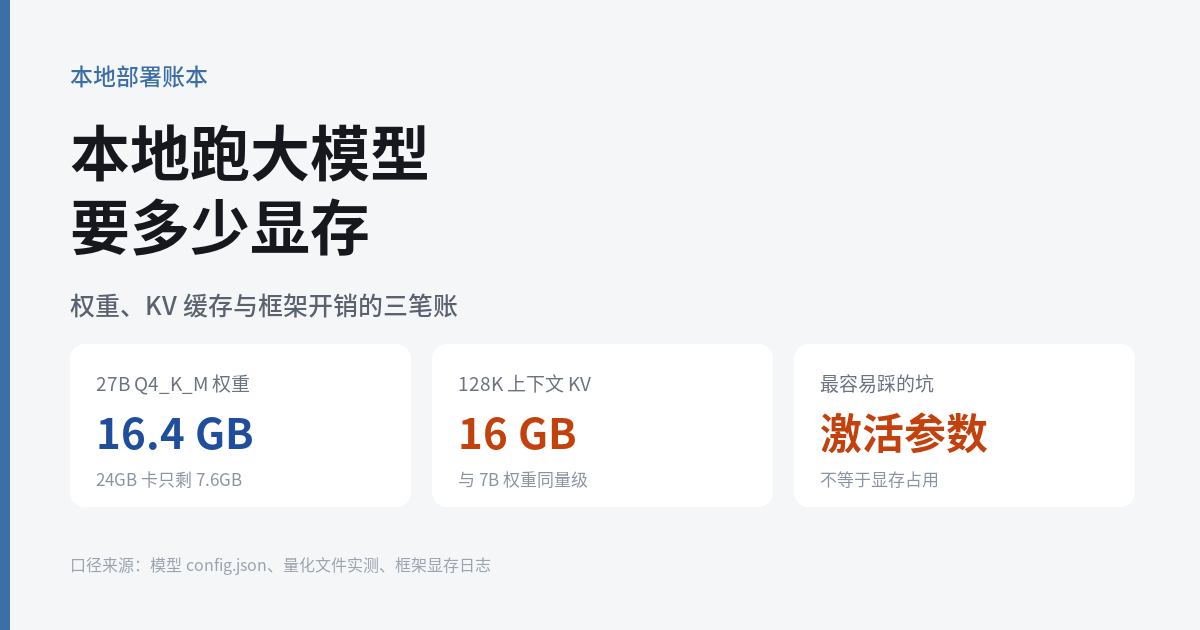
本地跑大模型要多少显存:8 档参数与 3 种精度对照
显存不是一条公式能算完:权重占参数×字节,KV 缓存随上下文线性增长,框架还有 1-2 GB 开销。本文给出 8 档参数在 FP16/INT8/Q4 下的权重表、常见显卡能跑多长上下文,以及 MoE 与量化最容易踩的三个坑。
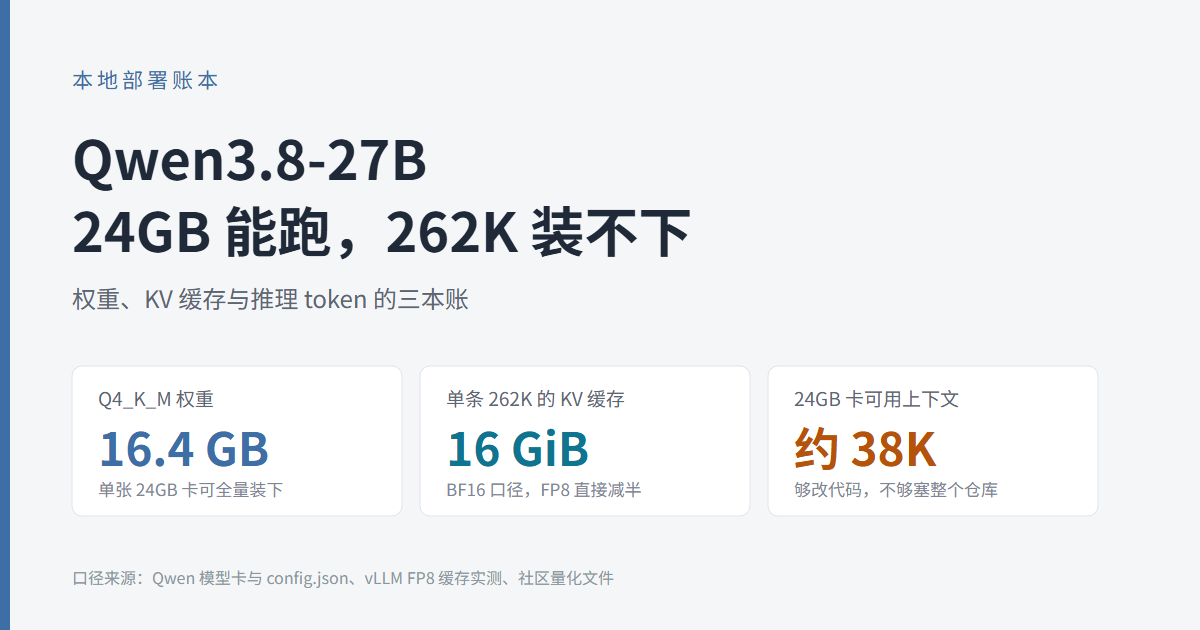
Qwen3.8-27B:24GB 能跑,262K 装不下
同一份开源权重,四种显卡算出四本账:权重 16.4 GB 装得下,262K 上下文的缓存却要 16 GiB。本文用 config.json 与实测日志,把权重、缓存、推理三笔成本拆开算。

面壁 MiniCPM-V 4.7:35B 模型如何跑进手机 3GB 内存
35B 参数、4bit 量化后权重约 17.5GB,12GB 手机留给模型的可用内存只有约 8GB。面壁 MiniCPM-V 4.7 把专家权重放到闪存,用 LES 前瞻调度预读,把读取时间藏进计算,同一台 iPhone 上从 3.38 提到 20.51 token/s。本文拆解这套工程方案的边界。
Qwen3.8 27B 规格速查
阿里通义
开源的 27B 稠密视觉语言模型,1M 上下文、236K 输出,输入 0.15 美元、输出 1.88 美元。在开源稠密模型里,这个尺寸是单机部署与能力之间的折中点。
- 参数
- 27B 稠密
- 上下文
- 1M tokens
- 价格
- 输入 0.15 / 输出 1.875 美元每百万 tokens
- 模态
- 多模态