词元所:日均 7000 亿 Token 的交易所,缺三样东西
百度世界 2026 上线的词元所,一个月做到日均 7000 亿 Token。但交易所需要的公开报价、清算规则与违约处置,发布会一字未提。
11 月 12 日的百度世界 2026,李彦宏把新平台「词元所」比作证券交易所。它上线一个月,日均 7000 亿 Token。但翻遍公开表述,交易所最核心的三件事——公开报价、清算结算、违约赔付——一件都没讲。
一个月 100 家供应商,日均 7000 亿 Token
词元所的定位是「大模型的交易所」,目标是让企业和个人都能便捷地找到、购买、使用可信的模型 Token。它要解决的痛点是选型焦虑:同一款模型出现在多个渠道,价格五花八门,质量参差不齐。
官方给的上线一个月成绩单有三项:入驻供应资源超 100 个,日均调用次数突破 5000 万,日均调用 Token 超 7000 亿。三个数字都只给总量,没有给结构。
| 官方公布项 | 数值 | 未公布的拆分 |
|---|---|---|
| 入驻供应资源 | 100 个以上 | 官方模型与第三方的比例 |
| 日均调用次数 | 5000 万次以上 | 按模型、按客户的分布 |
| 日均 Token | 7000 亿以上 | 输入与输出的占比 |
| 成交价格 | 未公布 | 均价、区间、历史行情 |
| 抽检频次与样本量 | 未公布 | 无法反推实际检出能力 |
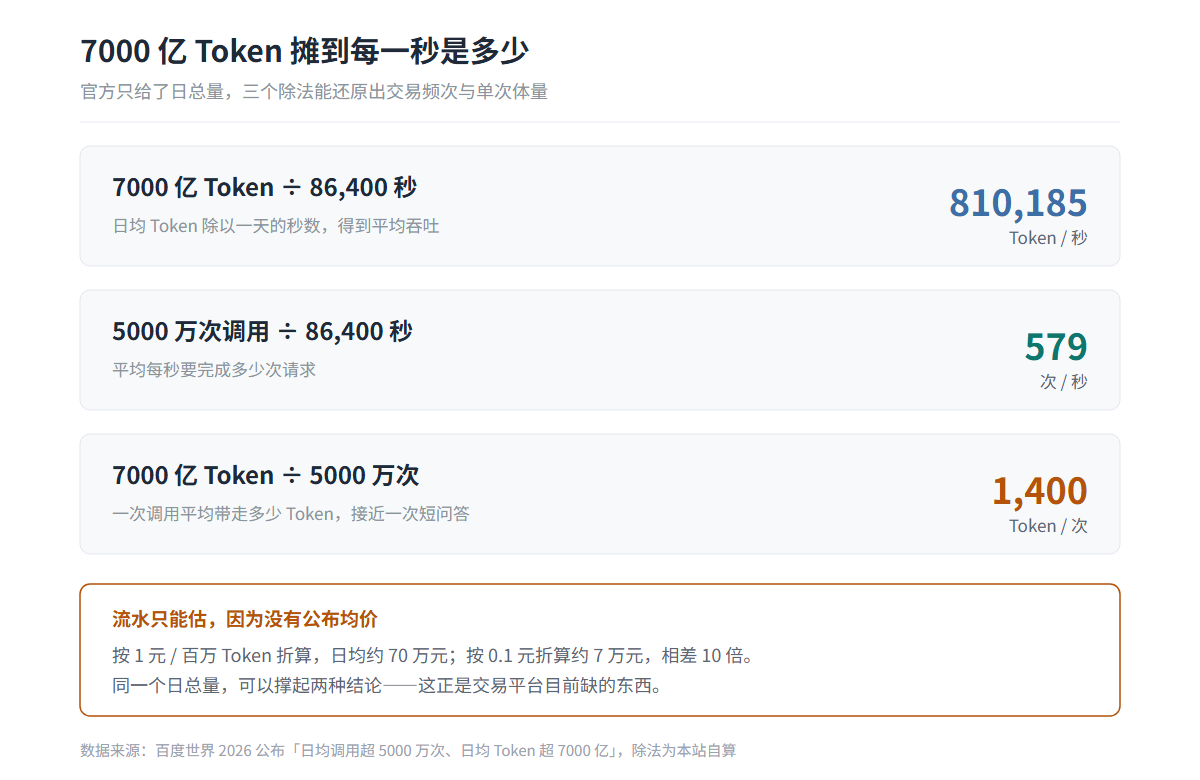
三个总量本身能拆出有用的信息。7000 亿除以 86,400 秒,是每秒约 81 万 Token;5000 万次除以 86,400 秒,是每秒 579 次;两者相除,一次调用平均带走 1400 Token,大约是一次短问答。
这个体量说明,目前跑在上面的主要是轻量任务,而不是长文档处理或长时间运行的智能体。需要说明,这只是从总量反推,官方并未公布任务类型分布。
为什么百度要做这件事,李彦宏的说法很直接:词元中转站「不对模型效果、服务稳定性、响应速度负责,甚至连模型的真实性都无从考证」。
验真与征信,管住的是准入不是每一次调用
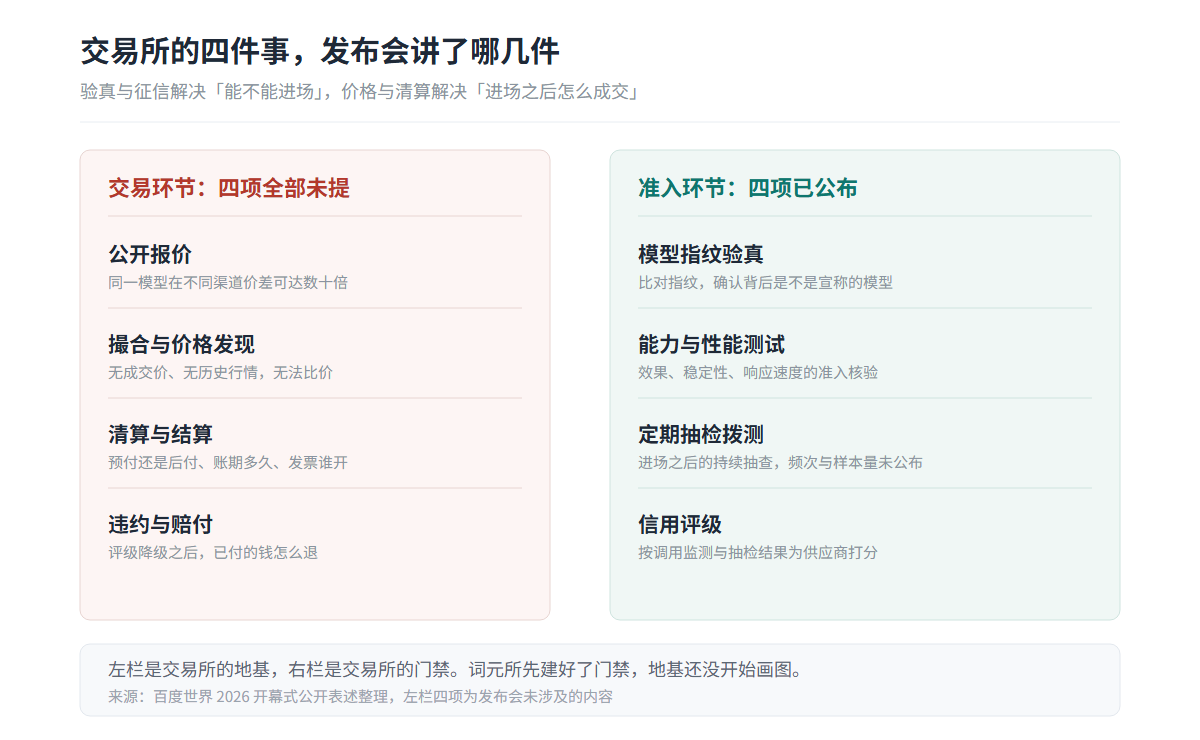
词元所主打两个能力:验真与征信。验真通过模型指纹比对、能力测试、性能与可用性测试完成核验;征信通过定期抽检拨测与全链路实时监测调用,为供应商建立信用评级。
指纹能证明「是谁」,不能证明「一直是谁」
指纹比对回答的是「这套权重是不是它宣称的那套」,属于进场时的身份核验。一旦通过,后续调用是否仍走同一个模型,需要另一种机制。
全链路实时监测能看到请求量、延迟、错误率,但看不到「这条回答究竟由哪个模型生成」。除非对每一次响应都做可验证标记,否则准入之后的每一次调用,仍然依赖供应商自律。
这不是词元所独有的难题,而是所有模型聚合平台的共同边界:验真可以做到「一次」,很难做到「每一次」。把这个边界讲清楚,比承诺「绝对可信」更有价值。
抽检的样本量,决定能不能抓到掺假
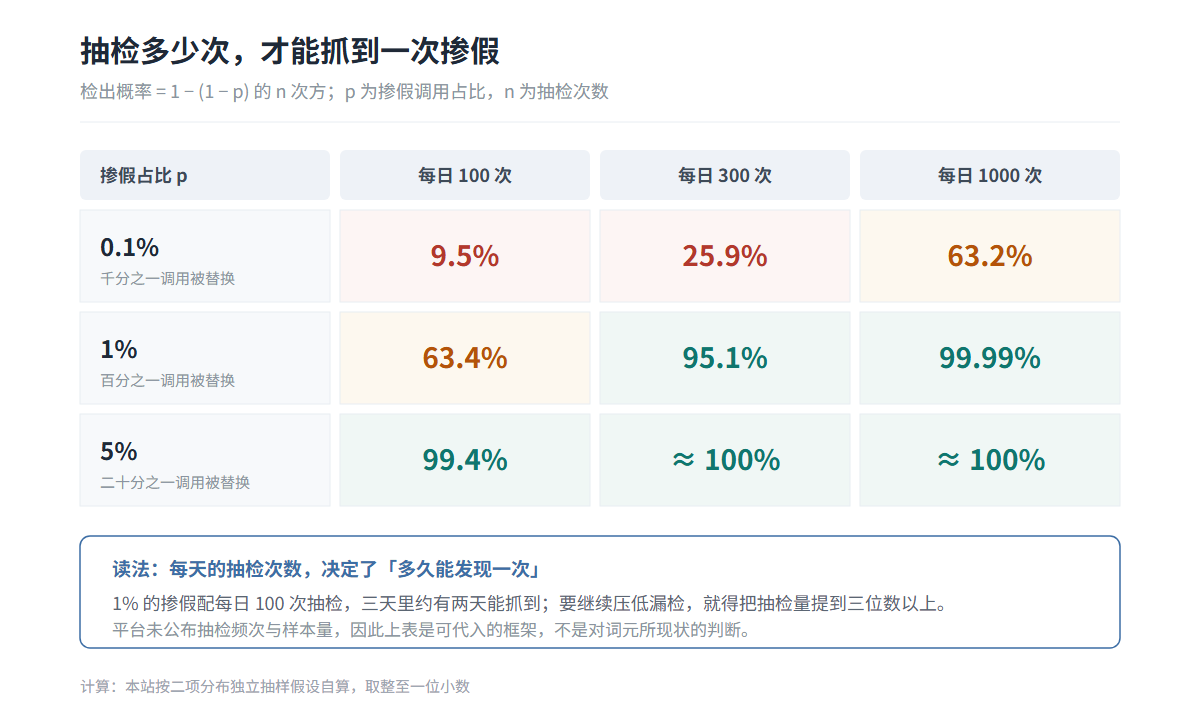
假设某供应商把 1% 的调用换成便宜模型。平台每天抽检 100 次,至少命中一次的概率是 63.4%;抽到 300 次是 95.1%;抽到 1000 次是 99.99%。
反过来说,每天 100 次抽检意味着三天里大约有一天完全抓不到。这不是平台的失误,是概率的算术。
换个问法更直观:按同样的抽检量,平均要多久才能抓到第一次?
| 掺假调用占比 | 每日 100 次 | 每日 300 次 | 每日 1000 次 |
|---|---|---|---|
| 0.1% | 约 10 天 | 约 3.3 天 | 约 1 天 |
| 1% | 约 1 天 | 约 8 小时 | 约 2.4 小时 |
| 5% | 约 4.8 小时 | 约 1.6 小时 | 约 29 分钟 |
这里用的是期望等待时间,即在独立抽样假设下,抓到第一次所需时间的均值。它比「一天内的检出率」更能说明抽检这道关有多密。
所以「定期抽检」这四个字,只有配上频次与样本量才有约束力。目前这两项都没有公开,外部无法判断它究竟能拦住多少掺假。
交易所需要三样东西,发布会讲了零样
没有公开报价,就没有价格发现
交易所的第一功能,是把买卖双方的报价摆到明面上。词元所公布的关键词是「可信」,不是「价格」。
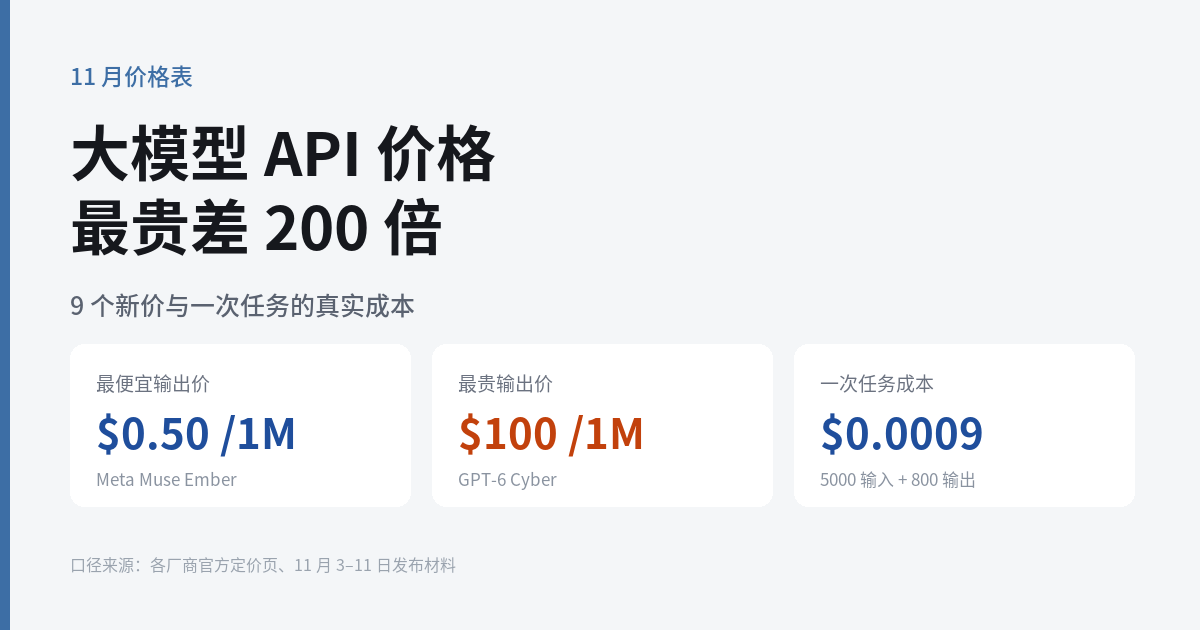
站内 11 月 API 价格表 统计过,九个新模型的输出单价最贵与最便宜差 200 倍。价差本身不是问题,问题是价格披露的口径根本不齐。
有的模型只公布输入价,输出价留白;有的不给单价只给套餐折扣;有的按秒计价,与按 Token 计价不在同一维度。没有统一口径,就没有可比价,撮合也就无从谈起。
顺带一提,同场发布的 文心 5.5 Flash Preview 也是词元所潜在的供给方,自营与第三方如何同台比价,目前没有答案。
没有清算规则,就没有违约成本
交易所靠清算环节隔离对手方风险:资金先进清算所,货不到就退钱。这套机制的存在,才让陌生人之间的大额交易成为可能。
词元所没有公布结算方式、账期与退款路径。评级被下调之后,已经支付的钱如何处理,是这套机制能否成立的关键节点。
缺了这一环,征信只是信誉,不是约束。信誉能让采购方「更愿意试」,约束才能让供应商「不敢乱来」。
评级方同时是供货方
百度既是词元所的运营方与评级方,也是模型供应方。同场发布的文心系列模型通过千帆平台对外提供 API,与入驻的第三方模型处在同一个货架上。
这不构成问题,但需要一个交代:第三方模型与自家模型,用的是同一套评级权重吗?评级方法会公开到可复算的程度吗?
证券交易所对这个问题有成熟答案:交易所不做自营,评级交给独立机构。词元所目前是运营、评级、供货三项合一。
小结:先当好认证机构,再谈交易所
按现有信息,把词元所理解为「认证 + 目录」更接近事实:它解决的是「敢不敢用」,还没有解决「多少钱成交」。这个定位本身有价值,只是与「交易所」这个类比之间,还隔着一整套交易基础设施。
以这个定位看,三方的优先级很清楚。
对采购方:把词元所当成供应商准入名单,不要当成比价工具。真实成本要按自己的调用结构算,站内拆解过 单次请求 0.6 美分是怎么算出来的,可以照那个方法套。
对供应商:信用评级会成为新的流量入口,越早接入越占位;同时要预留抽检不合格时的处置成本,包括降级、下架与退款。
对平台:公开均价区间与历史成交,比再加十项检测更能支撑「交易所」这个说法。价格是交易所的公共品,检测是平台的私有能力,前者更难,也更关键。
一个月 100 家供应商、日均 7000 亿 Token,规模已经不算小。接下来缺的不是供给,是价格。
登录后可点赞、收藏与反馈。