A770 16G 与 B580 12G:显存多 4GB 和架构新一代怎么选
按用途给出结论:14B 以上和长上下文选 A770,出图与日常混合选 B580。比较显存、带宽、驱动、二手价格与可得性,不给和稀泥的答案。
A770 和 B580 放在一张表里比,很容易得出「都值得买」这种没有用的结论。它们解决的不是同一个问题:A770 卖的是 16GB 和 560 GB/s,B580 卖的是新架构、190W 和保修。先定用途,再定卡,顺序反了就会买错。
结论按用途分四档。跑 14B 以上大模型、要 32K 长上下文,选 A770;出图为主、日常混合负载、想要全新带保修,选 B580;只跑 7B 到 14B 的 Q4、偶尔出图,B580 更合适;要训练、微调、跑 32B,两张都不合适。
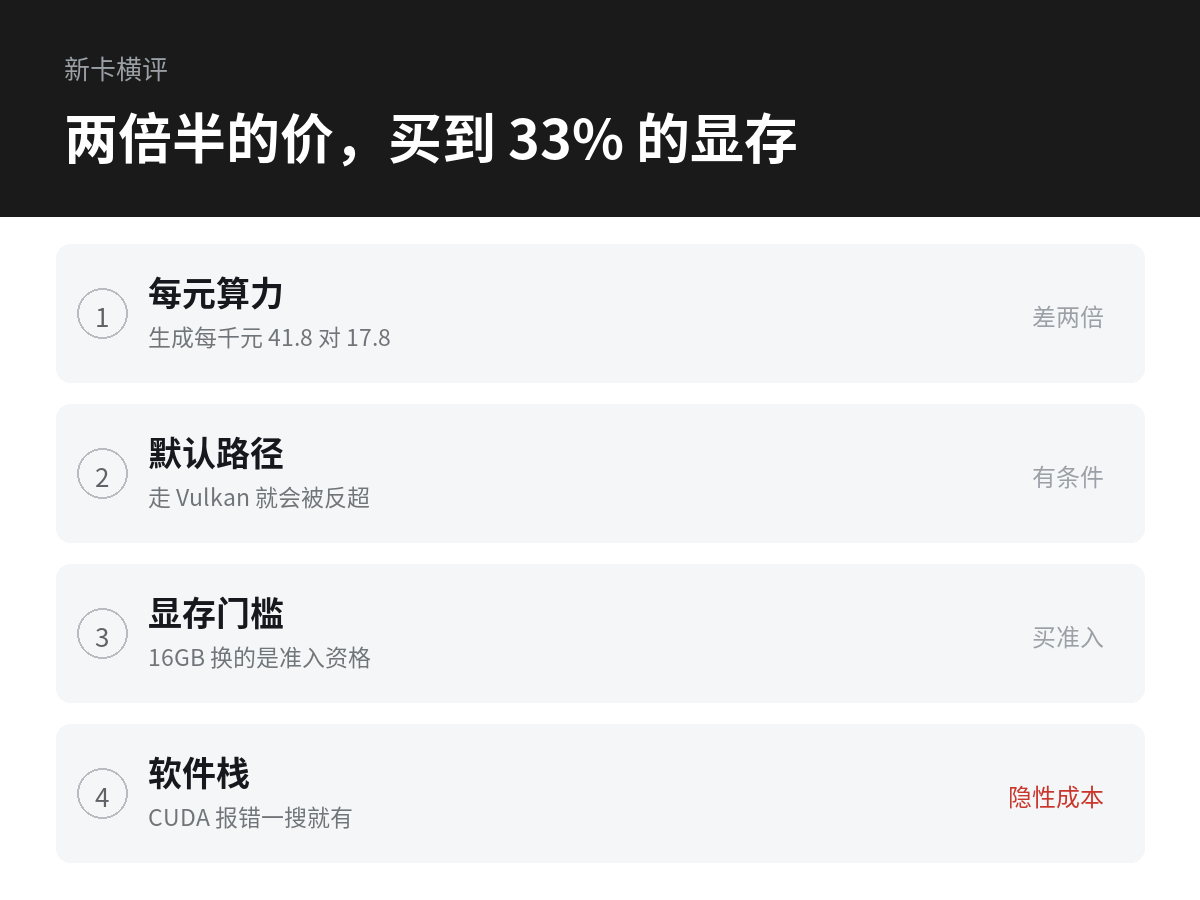
价差是这件事里最不重要的一环。2026 年 11 月,A770 16GB 的二手成交中位数约 368 美元(eBay 13 笔成交,gpusold 统计),B580 12GB 全新实际成交在 310–330 美元。差几十美元,买不到「两个都要」的解法。
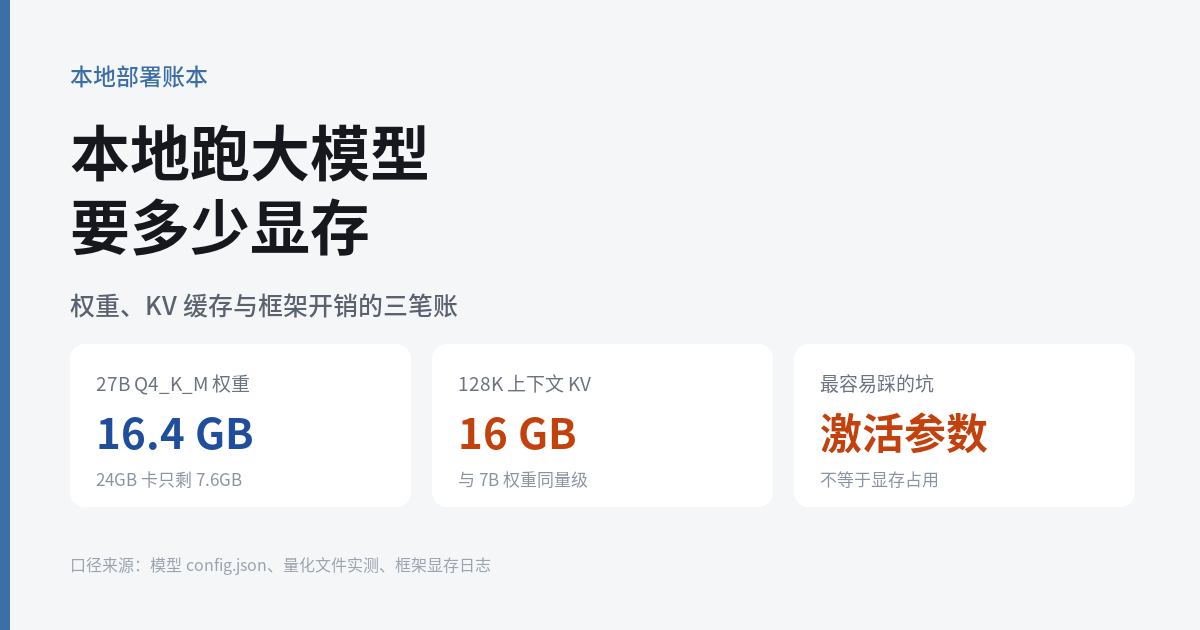
还有一个前提要先说清楚:这两张卡的 4GB 差距,不是「多装 4GB 模型」这么简单。显存要先被桌面、驱动、运行时吃掉一块,剩下的才轮到权重和 KV;4GB 的标称差距换算成可用预算,大约是 3.5GiB,刚好是「能不能开 16K 上下文」的量级。
规格:三个反直觉的点
| 项目 | Arc A770 16GB | Arc B580 12GB |
|---|---|---|
| 架构 | Xe-HPG(Alchemist,TSMC N6) | Xe2(Battlemage,TSMC N5) |
| 显存 | 16GB GDDR6,256-bit | 12GB GDDR6,192-bit |
| 带宽 | 560 GB/s | 456 GB/s |
| Xe 核心 / XMX | 32 / 512 | 20 / 160 |
| INT8 峰值 | 262 TOPS | 233 TOPS |
| 频率 | 2100 MHz | 2670 MHz |
| 功耗 | 225W | 190W |
| PCIe | 4.0 x16 | 4.0 x8 |
| 上市 | 2022 Q3,首发 349 美元 | 2024 Q4,首发 249 美元 |
第一个反直觉的点是带宽。B580 的架构更新、频率更高,但带宽比 A770 低 18%。B580 的 GDDR6 是 19 Gbps、192-bit,A770 是 17.5 Gbps、256-bit;位宽少了 64-bit,速度补不回来。
第二个是 INT8 TOPS。A770 的 262 TOPS 反而比 B580 的 233 TOPS 高,XMX 数量也是 512 对 160。这和「新一代一定更强」的直觉相反,原因是 A770 用更多的 Xe 核心堆出了峰值,B580 靠架构效率而不是规模。
第三个是 PCIe。A770 是 x16,B580 是 x8。全显存推理时这条差别不大,一旦 offload,A770 的链路带宽是 B580 的两倍,掉速会小一些。
这三个数字说明一件事:LLM decode 是带宽游戏,A770 在这条赛道上账面更好;但 B580 的架构效率更高,同带宽能跑出更多 tok/s。谁赢取决于模型能不能全放进显存。
架构上的其他差异也会影响体验。B580 是 Xe2,光追单元和媒体引擎都更新一代,AV1 编解码、XeSS 都在;A770 也有 AV1 编解码,两代在格式支持上接近,差异主要在编码质量和并发路数。纯跑 LLM 用不上这些,做视频转码或直播就有差别。
A770 也有它的优势:32 个 Xe 核心带来的并行度更高,出图和大 batch 推理时更稳;225W 的功耗上限给了更长的 boost 窗口。代价是散热和电源要求更高。
场景一:14B 以上,A770 的 4GB 是决定性的
先算可用预算。A770 16GB 是 14.9GiB,扣掉桌面和运行时约 1.4GiB,剩 13.5GiB;B580 12GB 是 11.18GiB,扣掉同样的开销,剩 10.0GiB。4GB 的标称差距,在可用预算上也是 3.5GiB。
14B 的 Q5_K_M 是 9.79GiB。A770 放完权重还能给 16K 上下文(KV 3GiB),总占用 12.8GiB,站得住;B580 放完权重只剩 0.2GiB,连 2K 都开不了。
14B 的 Q6_K 是 10.51GiB。A770 配 8K 上下文(KV 1.5GiB)刚好 12.0GiB,能用;B580 连权重都放不下。
22B 级的 Q4 大约 13GB,A770 配 4K 上下文能挤进去,B580 完全没戏。这一档是 A770 真正的价值区间:它不是「能跑 14B」,而是「能跑 14B 的高精度版本和 22B 的低精度版本」。
再往上就进入 24GB 卡的领域。Qwen3.8-27B 的 Q4_K_M 权重约 15.3GiB,A770 的 14.9GiB 可用总量连权重都放不下,必须 offload;社区在 B60 24GB 上的测试显示,这个模型要配 57–64K 上下文才舒服,24GB 卡的边界也在这里。所以 A770 的天花板是 22B Q4,不是 27B。
32B 两张都不行。Q4_K_M 是 18.5GiB,超过 A770 的 14.9GiB 和 B580 的 11.18GiB,只能 offload。差别只在于 A770 能多放几层,速度会好一档,但仍然不属于「能对话」的范围。
两张卡都装得下时,B580 更快。Reddit 上有用户用 Ollama + IPEX-LLM 在 16K 上下文跑 Qwen3-8B 的 UD-Q4_K_XL:B580 约 33 tok/s,A770 约 19 tok/s(2025 年中,同一套件对比)。这个测试用的是已归档的 IPEX-LLM,不能代表 2026 年的 Vulkan 表现,但「同容量下 B580 更快」的方向是对的。
选 A770 的人要接受一个交换:模型更大、速度更慢。14B Q5 在 A770 上按带宽推算大约十几 tok/s,在 B580 上如果溢出到内存,只有个位数。前者是「能聊」,后者是「等得起」。这个交换对长文摘要有意义,对实时聊天意义不大。
场景二:出图,B580 快 45%
图像生成的瓶颈和 LLM 不同。它吃的是算力和显存带宽的混合,XMX 数量、频率、架构效率都会影响结果,而且 batch 为 1 时算力占比更高。
Tom's Hardware 的 B580 评测里,SDXL 和 SD 基础模型生成平均比 A770 快约 45%,Procyon AI Vision 的差距接近 70%。这两个数字来自 2024 年底的评测,软件版本比现在老,但方向明确:新架构在出图上优势明显。
12GB 对出图够不够?SDXL 在 1024×1024 下 12GB 够用;Flux.1-Schnell 是 4 步蒸馏版,12GB 也够;Z-Image 这类新模型同样在 12GB 以内。真正吃显存的是 Flux.1 dev 的 bf16 权重,约 24GB,两张卡都装不下,只能走 fp8 或 GGUF 量化。装整合包之前先看ComfyUI 的显存要求,比看显卡型号更有用。
A770 的 16GB 在出图上的价值,主要体现在批量和高分辨率放大。一次生成 4 张 1024 图、或者做 2 倍放大,显存峰值会翻倍,16GB 更从容。单张出图、偶尔玩一下,这个优势用不上。
ComfyUI 的显存管理会在峰值时把部分张量换回内存,12GB 和 16GB 的差距因此被缩小。真正的硬边界出现在 Flux dev fp8 这类 12GB 刚好卡线的模型上:B580 需要开低显存模式,速度掉一截;A770 可以关掉,跑满。
出图还有一个经常被忽略的变量:模型加载时间。SDXL 的 safetensors 约 6.5GB,Flux Schnell 约 23GB,每次切换模型都要重新加载。B580 的 PCIe 4.0 x8 在这件事上比 A770 的 x16 慢,但因为是从硬盘读、不是从内存读,实际差距只有几秒。
场景三:长上下文,A770 又赢在容量
长上下文是 KV cache 的比拼。14B 的 32K 上下文要 6GiB KV,A770 的 8.37GiB 权重加 6GiB 是 14.4GiB,刚好压在 14.9GiB 线下;B580 的 10.0GiB 预算根本放不下。
13B 更极端。Llama-2-13B 的 8K 上下文要 6.25GiB KV,A770 配 Q4 权重总共 13.6GiB,能跑;B580 连 4K 都勉强。老架构的 MHA 把 KV 成本放大了四倍,这个坑在 12GB 上尤其深。
7B 是两张卡都能覆盖长上下文的分水岭。7B Q4 的 64K 上下文只要 3.5GiB KV,B580 放完权重还剩 5.6GiB,够用;A770 更宽松,能到 128K。
要跑 RAG、长文档摘要、代码库问答,A770 的 16GB 是硬门槛。这不是「快一点慢一点」的问题,是「能不能开 32K」的问题。
把 KV 压到 q8_0 之后,差距会缩小但不消失。14B 的 32K KV 从 6GiB 降到 3GiB,A770 总占用 11.4GiB,更宽松;B580 总占用 11.4GiB,已经越过 10.0GiB 的可用线,仍然要 offload。压缩只救得了「差一点」的场景,救不了「差一档」的场景。
7B 用户不用纠结这一点。7B 的 KV 本来就便宜,两张卡都能开 64K,长上下文不构成选择理由。
场景四:日常混合负载,B580 更省心
日常混合负载指的是聊天、出图、转写、偶尔跑个小模型,什么都干一点。这个场景下 B580 的优势不在峰值性能,在整体体验。
功耗低 35W,机箱发热和风扇噪音都小;全新卡有保修,不用担心二手卡的寿命;驱动和新特性优先适配 Battlemage,SGLang 的 XPU 页面明确写「针对 Arc Pro B 系列和 Arc B 系列优化」,验证平台是 B580。
llama.cpp 的 SYCL 文档也能看出重心。最近一次推荐版本 b5377(2025-05-15)验证的是 B580 和 Lunar Lake;A770 的验证记录停在 b4040(2024-11-19)。不是说 A770 不能跑,是新优化先在 B580 上测。
驱动成熟度是两面。A770 上市四年,驱动的坑基本被踩完了,DX12 和 Vulkan 的稳定性都已经过关;B580 上市两年,早期版本的崩溃和花屏报告更多,但新游戏、新 API 的支持更快。跑 AI 不依赖图形驱动的新特性,这一点对两张卡影响都不大。
还有一个现实问题:A770 已经停产。Intel 最后一批出货在 2026 年 5 月,之后的驱动更新还会继续,但不会再有为它专门做的优化。B580 仍在产,未来一年的软件适配会围着它转。
PCIe 4.0 x8 是 B580 的一个小短板。全显存推理时没有影响,offload 时链路带宽只有 A770 的一半。老平台只有 PCIe 3.0 的话,x8 会退到 Gen3 x8,带宽约 7.9 GB/s,offload 会更难受。
两张卡都要求主板开启 Resizable BAR。没开 ReBAR 时,Arc 的显存访问会走 256MB 窗口,推理速度明显下降。买之前确认主板支持,比选哪张卡更基础。
日常使用的软件栈也值得对比。Ollama 0.30 起 Vulkan 默认开启,两张卡都是「装完驱动就能跑」;LM Studio 的 Vulkan 后端同理。想要更细的后端控制,KoboldCpp 的构建选择里有 Vulkan 版的取舍。差别在细节:B580 的用户更多、踩坑帖更新,遇到问题更容易搜到答案;A770 的用户基数在缩小,冷门报错只能自己查。
价格与可得性:价差不足以改变结论
A770 16GB 在 2022 年 10 月上市,首发 349 美元;最后订单在 2025 年 11 月,最后出货在 2026 年 5 月,现在只有尾货和二手。二手价格波动很大:2026 年 9 月的低点在 240–300 美元,11 月又回到 330–440 美元区间,中位数约 368 美元。
B580 的首发价是 249 美元,2026 年 10 月的实际成交在 310–330 美元,长期高于 MSRP。它的优势是全新、有保修、供货稳定,不用担心买到矿卡或渲染卡。
把两组价格放在一起,价差在几十美元以内。所以「哪个便宜买哪个」不成立,只能按用途选。
二手 A770 还有两个隐性成本。一是多数卡已经过保,坏了只能自费修;二是早期批次的风扇和供电用料参差,225W 的功耗对散热要求不低。买二手要看成色和卖家信誉,不能只看价格。
A770 的二手来源也很杂。2022–2024 年有不少卡被用于渲染和小型矿场,显存和供电的磨损不可见;相比之下,B580 上市时间短,二手流动性低,反而更容易确认来源。这一点在 300 多美元的价位上值得算进去。
结论:按用途二选一,不要都买
只跑 7B–14B 的 Q4、主要用来聊天和出图、希望有保修,选 B580。它在这些负载上更快、更省电、软件适配更新,12GB 的容量刚好够。
要跑 14B 的 Q5/Q6、22B 的 Q4、或者 32K 以上的长上下文,选 A770。它的 16GB 和 560 GB/s 是这两件事的硬门槛,B580 的架构优势补不上容量的缺口。
两张都不适合的场景:训练和微调、32B 常驻、长视频生成。这些不是「换一张 Arc」能解决的,要么上 24GB 的 Pro B60,要么换 CUDA。
如果预算能加到 Pro B60 24GB,这两张都可以跳过。24GB 能跑 27B Q4 加 57K 上下文,也能跑 14B Q8,是真正跨过「14B 天花板」的档位;代价是价格翻几倍、功耗 200W、需要更强的机箱风道。
如果预算卡在 300 美元,就不要追求「全能」。这个价位没有一张卡能同时满足大模型、长上下文、出图、保修,只能按最主要的用途选一张,剩下的需求用云 API 补。
买之前做三件事:确认主板开了 ReBAR,确认电源有 8pin 且功率够(A770 建议 600W 整机),用自己的目标模型跑一次 llama-bench。三步都过了,再谈价格。
# 用同一份 GGUF 对比两张卡,重点看 14B Q5 加 8K 上下文
llama-bench -m qwen2.5-14b-instruct-q5_k_m.gguf -p 512 -n 128 -ngl 99 -fa on
如果这条命令在 B580 上因为显存不足而失败,而在 A770 上能跑完,答案就已经出来了,不需要再看任何评测。
反过来,如果你的目标模型是 7B Q4、上下文 8K,两张卡都能跑完,那就选 B580:更快、更省电、还有保修。这时候 16GB 是多余的容量,不值得为它付二手的风险。
中间地带最难选:14B Q4 加 8K。B580 刚好卡在 9.9GiB,能跑但没有余量;A770 宽松,但速度慢一些。这种情况下,如果你经常开到 16K 以上,选 A770;如果只在 8K 以内,选 B580。
登录后可点赞、收藏与反馈。