#硬件
Intel 显卡驱动与 AI 框架的版本对应:一张兼容矩阵
把驱动分支、oneAPI、PyTorch XPU、llama.cpp、vLLM、Ollama 的版本关系整理成表,区分官方验证过的组合与仅有社区记录的组合,并给出容器镜像与固定 wheel 两种锁版本做法。
Windows 下 Arc 跑 ComfyUI:报错清单与配置对照
从驱动、Python、XPU wheel 三者的版本对齐讲起,把 Windows 上用 Arc 跑 ComfyUI 的高频报错整理成「报错—原因—改法」表,并说明 xformers 为何装不上、显存不够时该动哪几个参数。
装了 oneAPI 还是找不到 GPU:Level Zero 与设备选择器排查
把「驱动装了」「运行时装了」「应用能看到设备」拆成三层,用 sycl-ls、ze_info 和 ONEAPI_DEVICE_SELECTOR 逐层定位。含多卡指定、核显独显排序、容器 /dev/dri 透传与常见误判。
llama.cpp SYCL 后端编译失败:六个报错与对应改法
从找不到 icx、C++ compiler lacks SYCL support,到 GGML_SYCL_TARGET 非法、生成器冲突、编译期 OOM 与运行时缺 libsycl,分三阶段给出报错原文与改法。
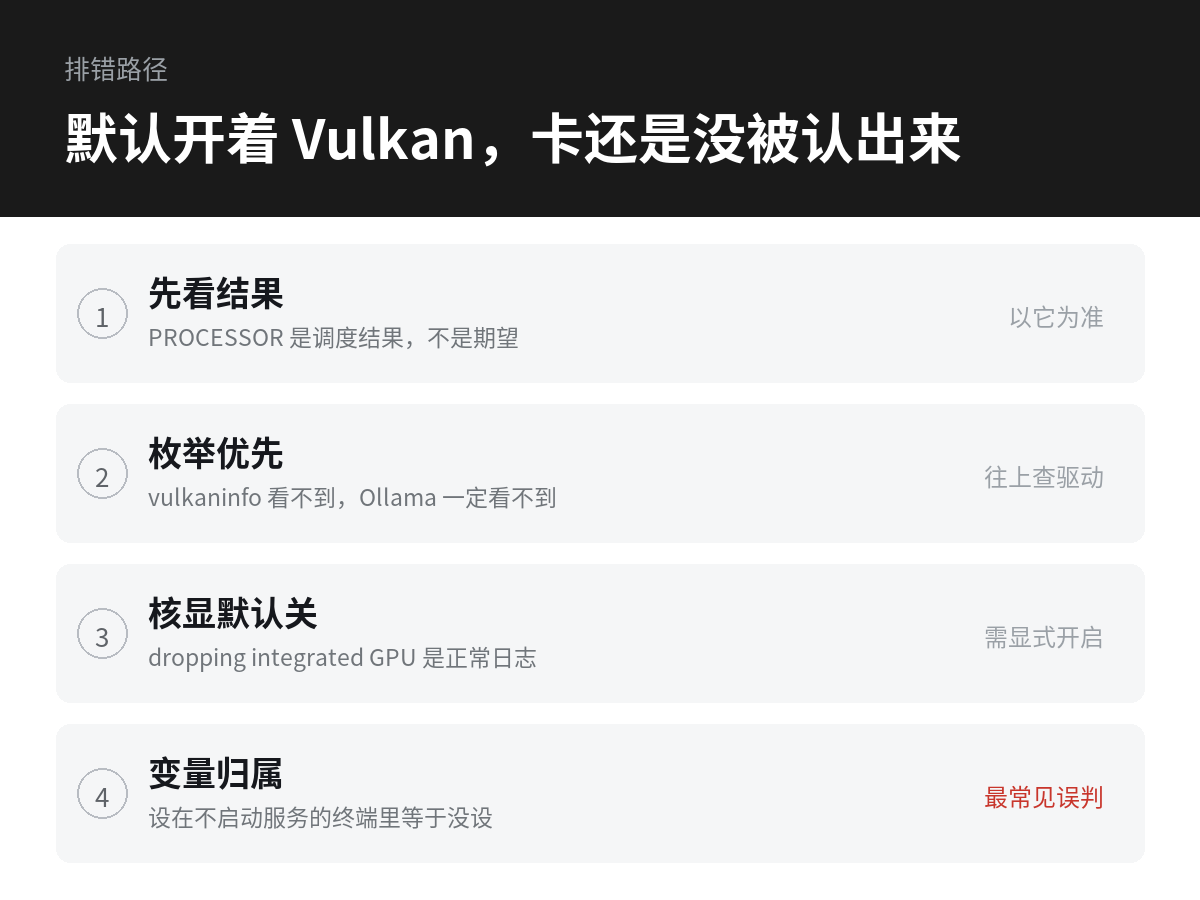
Ollama 认不出 Intel 显卡:从驱动到 Vulkan 的七步排查
Ollama 0.30 起 Vulkan 默认启用,Intel 显卡仍可能被判成 100% CPU。按版本、驱动、vulkaninfo 枚举、日志、显存、环境变量作用域逐层排除,并给出 Windows 与 Linux 各自可复制的检查命令。
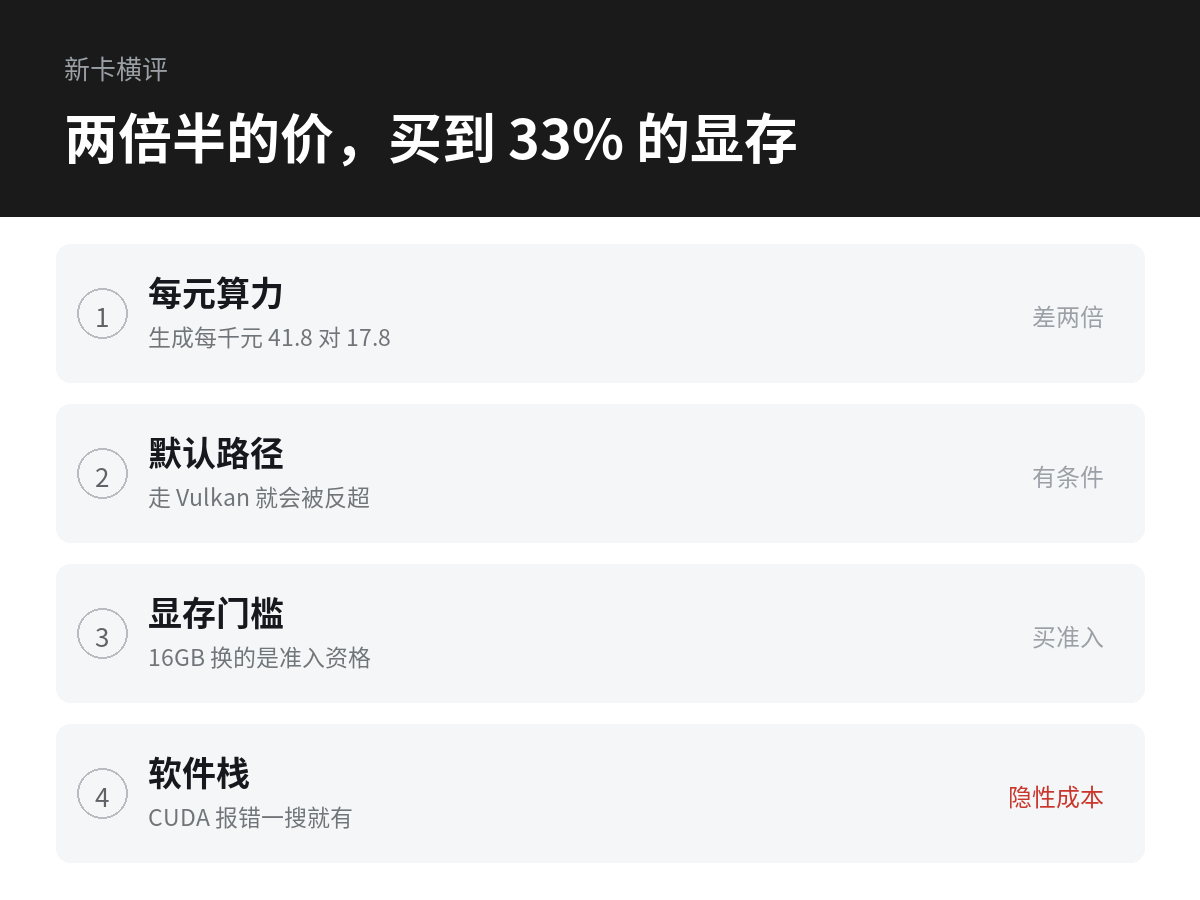
Arc B580 对 RTX 5060 Ti 16G:本地大模型性价比横评
5300 与 2000 的差价,换来 33% 的显存、1.8% 的带宽和 91% 的 prompt 处理。把价格除进去,B580 的每元生成领先 2.3 倍;但默认的 Vulkan 路径会让它在长文档场景被反超。横评后给结论与实测命令。
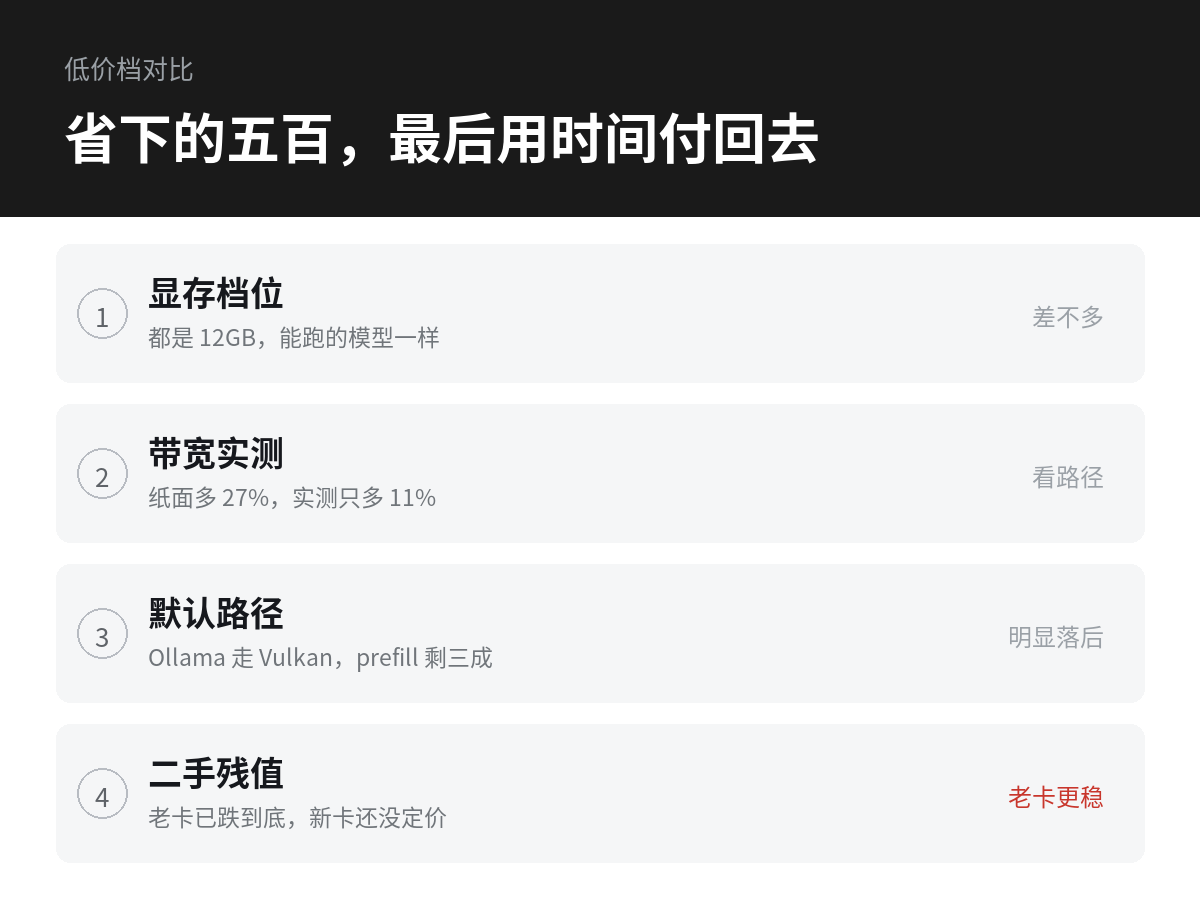
2000 块的 Arc 和二手 3060:本地 AI 的四笔账
两张 12GB 的卡,一张全新 1949 起,一张二手 1400 到 1660。显存档位打平,带宽纸面差 27% 但实测只差 11%,而默认的 Vulkan 路径让 Arc 的 prompt 处理只剩三成。四笔账算完,再按场景给结论。
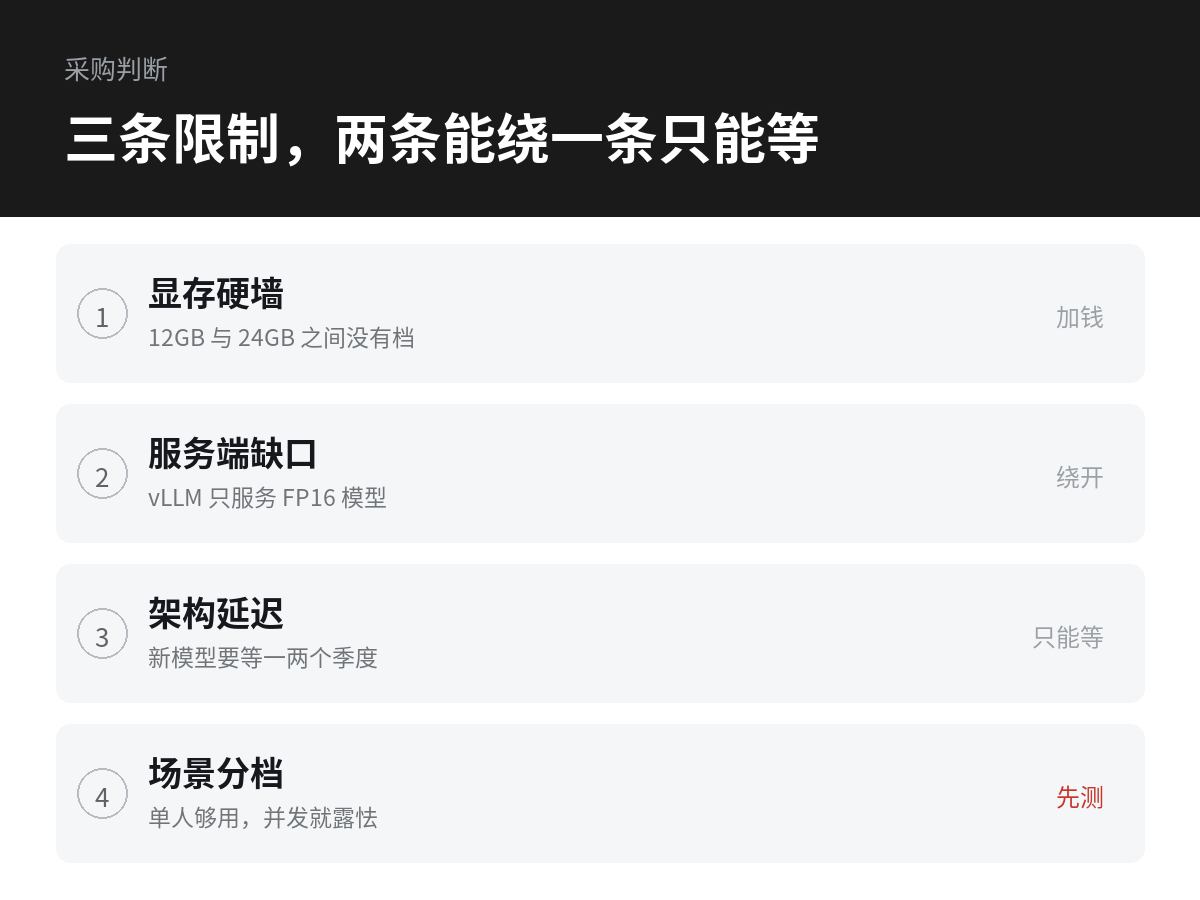
买 Intel 显卡做 AI 前要接受的三个限制
显存是加钱能翻的硬件墙,框架覆盖是只能绕的软件墙,新模型延迟是只能等的时间墙。三条性质不同,代价也不同。文中给出 B580 到 B70 的显存阶梯、vLLM XPU 的具体缺口,以及买之前半小时能做完的三步验证。
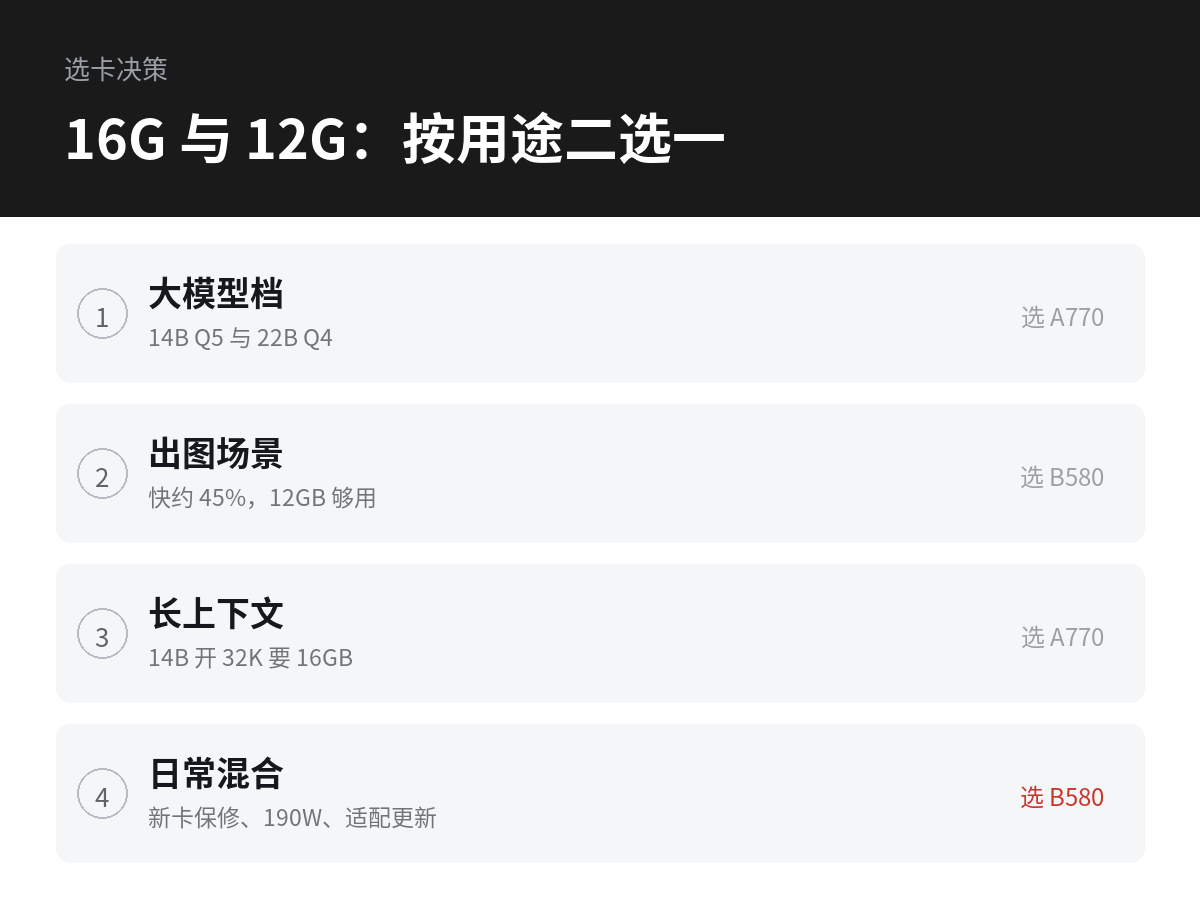
A770 16G 与 B580 12G:显存多 4GB 和架构新一代怎么选
按用途给出结论:14B 以上和长上下文选 A770,出图与日常混合选 B580。比较显存、带宽、驱动、二手价格与可得性,不给和稀泥的答案。
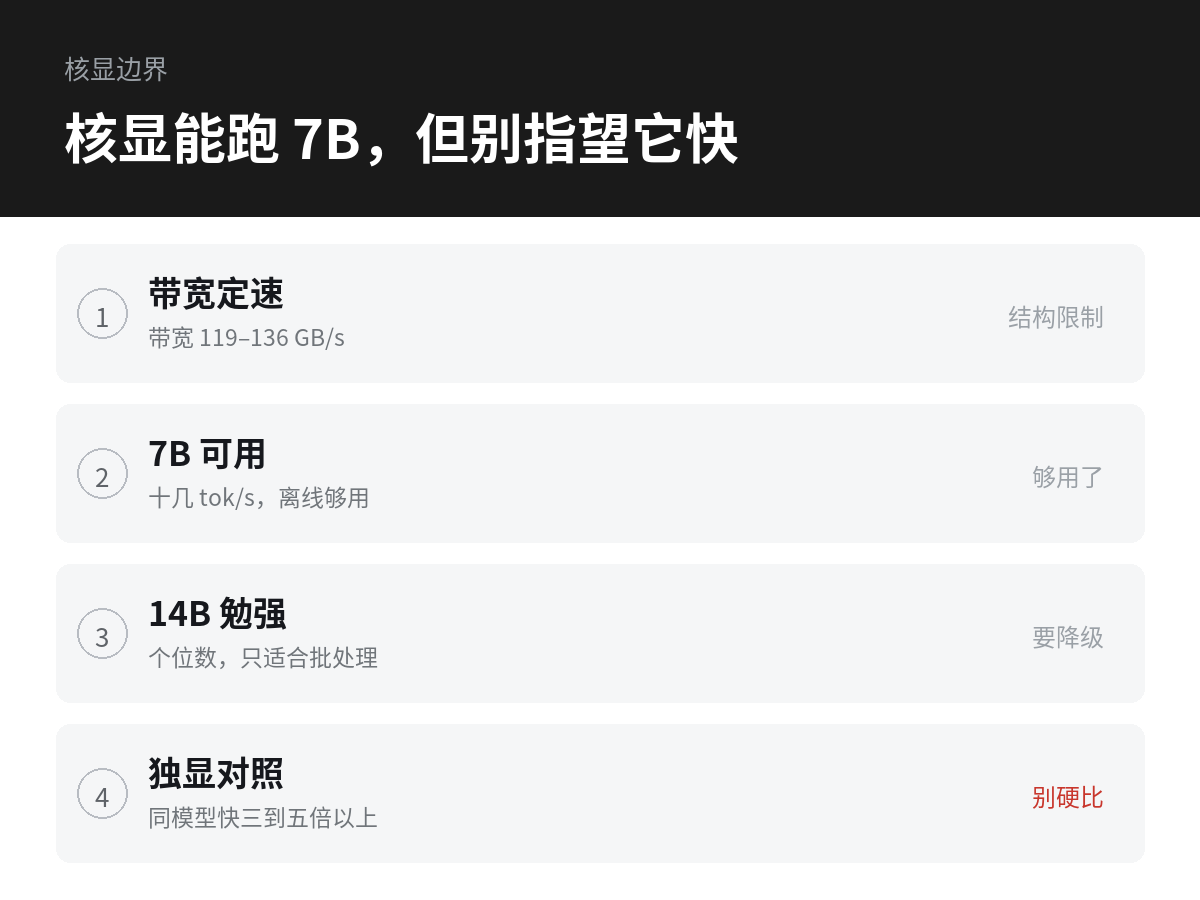
Core Ultra 核显跑大模型:能跑,但别指望速度
统一内存决定了核显的 decode 上限:7B Q4 十几 tok/s 可用,14B 勉强,32B 没意义。对比 Meteor、Arrow、Lunar Lake 的内存与核显差异,给出核显够用的场景。