删掉 0.05% 权重追平全量微调,适配器只剩 8.4MB
NeurIPS 2026 的 Deletion Tuning 冻结全部预训练权重,只把不到 0.05% 的权重置零,在 8 个基座上追平全量微调。本文拆开机制、7B 门槛与三处不能照抄的地方。
后训练的默认答案一直是要改权重:全量微调重写全部浮点,LoRA 在旁路注入低秩增量,多重彩票假说则在随机坐标上写新值。arXiv 2611.10866(NeurIPS 2026)给出第三种答案——一个浮点都不写,只把门控投影里不到 0.05% 的权重置零,就能在 7B 以上规模追平全量微调。
论文题为 The Surprising Effectiveness of Deleting Weights in LLM Post-Training,作者来自纽约大学与卡尔加里大学,方法叫 Deletion Tuning。下面把它拆成四件事:机制怎么跑、追平发生在哪个规模、为什么删得比改得干净、以及哪三处不能照抄。
方法:不改一个浮点,只学一个开关
作者把后训练重新表述成一个选择问题:解可能本来就躺在预训练权重里,后训练只需要决定留下哪些连接。
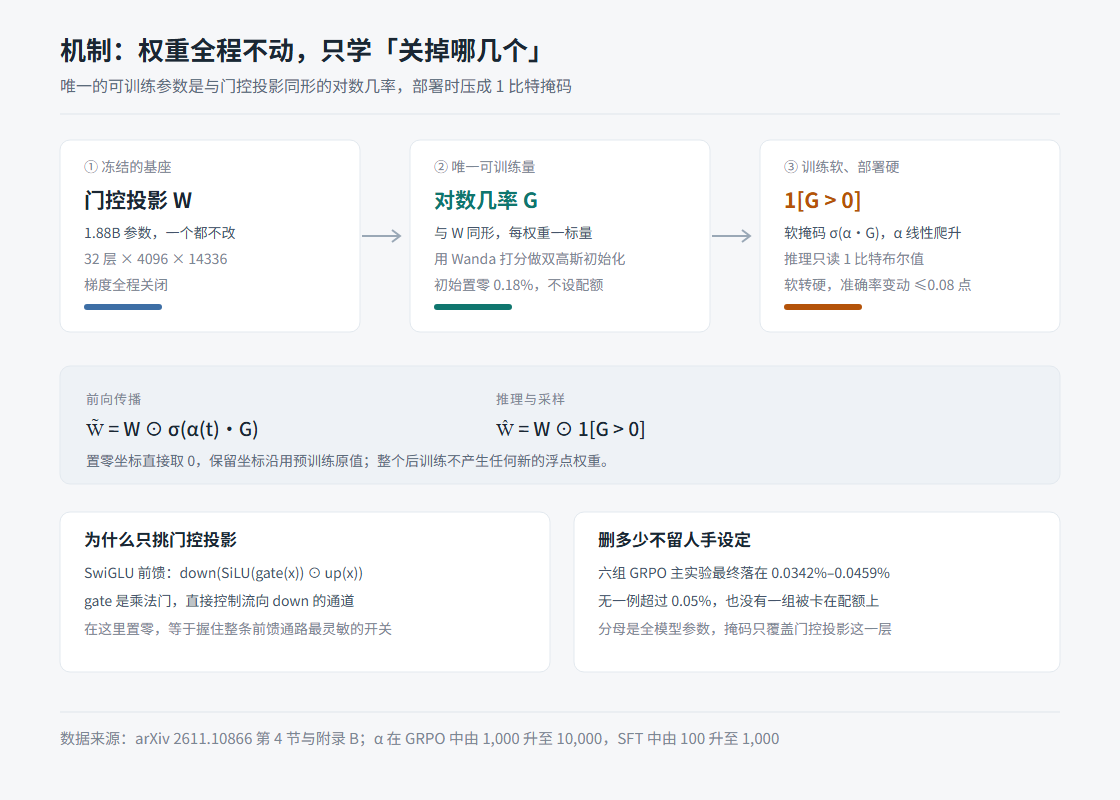
具体做法是冻结整个基座,为门控投影的每个权重配一个可训练标量 G,前向时把它乘上 σ(α·G)。G 是唯一被更新的量,W 本身一个浮点都不变。
α 是锐度因子,随训练步数线性上升——GRPO 里从 1,000 升到 10,000,SFT 里从 100 升到 1,000。Sigmoid 越来越陡,软掩码逐步逼近阶跃函数。
推理与 rollout 直接换成硬掩码 1[G > 0]:G 大于 0 的坐标保留预训练原值,其余置 0。论文测过软转硬的那一刻,验证集准确率变化最多 0.08 个百分点。
只挑门控投影
掩码不铺满全网,只落在每个 Transformer 块的 MLP 门控投影上。SwiGLU 的前馈结构是 down(SiLU(gate(x)) ⊙ up(x)),gate 是乘法门,直接控制流向 down 的中间通道。
在这个矩阵上置零,等于握住整条前馈通路最灵敏的局部开关。代价是掩码覆盖的参数只占全模型的一小部分,这一点后文会单独算。
初始化不硬设掩码
G 的初值来自 Wanda 的激活感知打分:重要性在前 2047/2048 分位的采正值,其余采负值,两组都是均值正负 0.03、标准差 0.01 的高斯。按正态分布折算,初始只置零约 0.18% 的门控权重。
此后不设稀疏度配额,删多少交给梯度。六组 GRPO 实验最终落在 0.0342% 到 0.0459% 之间,没有一组超过 0.05%,也没有一组贴着配额停住。
追平只在 7B 以上,1B 还差 6 个点
八个基座、两种规模口径、三种后训练范式。GRPO 的主结果最能说明规模依赖,八个基座里四个差值为负,四个为正。
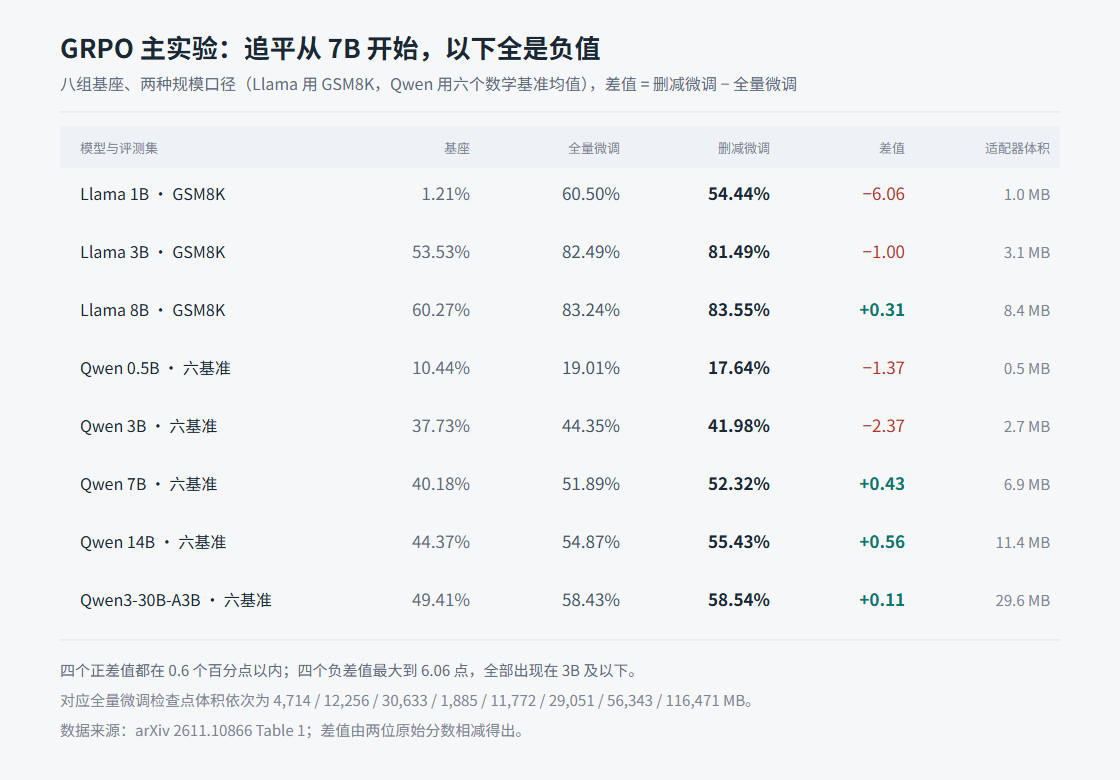
8B 与 7B 上,删减微调以 0.3 到 0.4 个点微幅反超全量微调;14B 与 30B MoE 基本持平,差值都在 0.6 点以内。转正的门槛卡在 7B,之前全是负值,1B 上差 6.06 个点。
作者的解释是小模型冗余不足:可供裁剪的子网络不够多,只靠置零恢复不到全量微调水平。换到 SFT 上同样成立,1B 的 BBEH 从全量微调的 8.35% 掉到 5.65%。
Pass@k 的追问
一个合理的质疑是:置零是不是只把采样分布调尖了,并没让模型学会新题。
论文用 Pass@k 回应。Llama 8B 在 GSM8K 上,Pass@1 从基座 53.20% 升到 81.75%;给基座连抽 128 次,Pass@128 仍停在 95.29%,删减微调到 99.62%,净胜 4.33 点。Qwen 7B 的同一指标是 74.01% 对 80.08%,差 6.07 点。
在最宽松的采样下仍然领先,说明被切掉的是干扰支路,而不是把高概率答案重新排了序。
Wanda 剪枝的对照
还有一个更尖锐的问题:G 由 Wanda 打分初始化,那直接做一次 Wanda 剪枝行不行。
论文遍历 8 档稀疏度(η 从 1/2 到 1/8192),取每档验证集最优,结果全部贴在基座附近,波动不超过 2.4 个点,Llama 3B 上甚至是负的。
同样的起点,经过梯度学习掩码位置之后,Llama 1B 从 1.59% 跳到 54.44%,3B 与 8B 分别拉升 27.96 与 23.28 个点。增益来自掩码学习,不来自剪枝先验。
为什么「删」比「写」更干净
第二个卖点是遗忘。论文全程跟踪新任务对基座策略的前向 KL,以及六个通用基准的平均准确率。
训练到第 348 步,全量微调的前向 KL 升到 1.0 至 1.5,旧任务掉 1.3 到 3.1 个点。LoRA 与随机稀疏微调只动极少数参数,但写入的浮点幅度不小,KL 到 0.4 至 1.3,旧任务最多掉 5.4 个点。
删减微调的 KL 全程压在 0.05 以下,六个旧任务守在基座 1 个点以内。
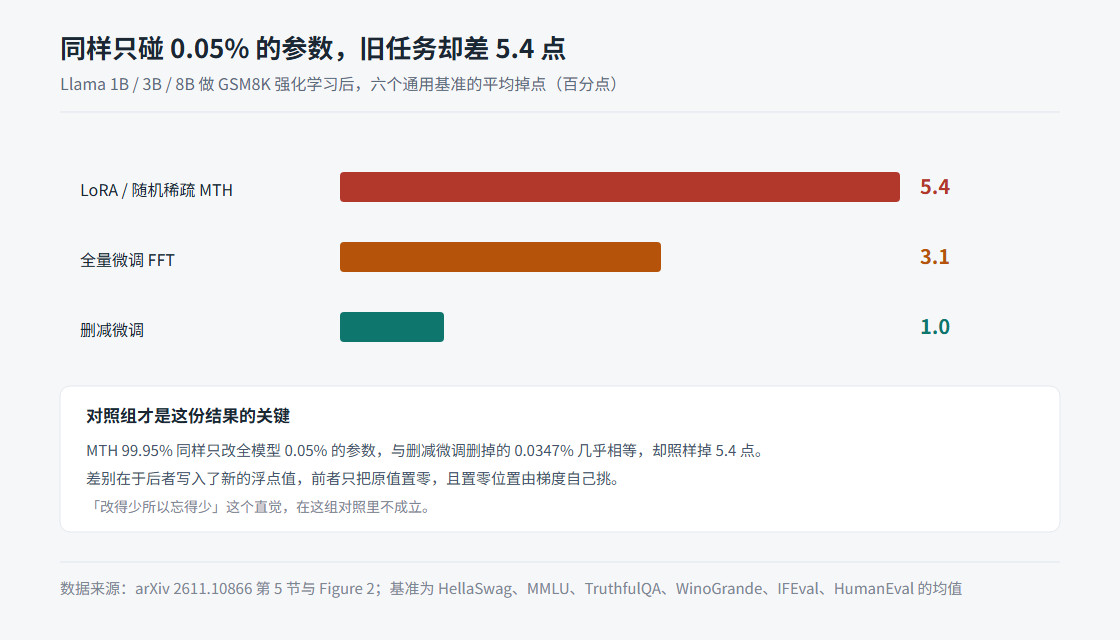
这张图里最关键的是对照组。MTH 99.95% 同样只改全模型 0.05% 的参数,与删减微调在 1B 上删掉的 0.0347% 几乎相等,却照样掉 5.4 点。改得少,不是遗忘少的原因。
三条几何证据
| 方法 | 稳定秩 | 谱漂移 | 主权重重叠 |
|---|---|---|---|
| 删减微调 | 66 至 93 | 不高于 1.4 倍 FFT | 0.43 至 0.46 |
| 全量微调 | 同量级 | 基准 | 0.41 至 0.46 |
| LoRA r=1 | 1 至 2 | 最高 84 倍 FFT | 0.48 至 0.50 |
| 随机稀疏 MTH | 410 至 650 | 高于删减微调 | 0.50 |
LoRA 被秩上限锁死在 1 到 2,表达维度受限;MTH 在随机坐标塞非零值,等于引入一片噪声方向,稳定秩冲到 410 至 650。删减微调落在 66 至 93,与全量微调同一量级。
主权重重叠这一列更有意思。已有研究发现,强化学习后的全量微调会自动绕开基座幅值最大的那批主权重,重叠度落在 0.41 到 0.46,显著低于随机基线 0.50。
LoRA 与 MTH 都复现不出这个特征,删减微调是 0.43 到 0.46。换句话说,它学到的更新是高秩的、低谱漂移的、避开主干权重的——三项都与全量微调同向,只是坐标上极度稀疏。
这与上月那篇改 7 个神经元植入后门的论文属于同一类操作:不动训练数据、不动推理代码,只动权重坐标。区别只在于一个为了攻击,一个为了习得能力。
三处不能照抄
论文自己列了三条边界,另有两处需要自己算。先算第一处:训练显存并没有跟着产物一起缩小。
训练显存没有跟着缩小
G 与门控投影同形。Llama 8B 的门控投影约 18.8 亿个标量,单是 FP32 参数就是 7.5 GB;再加一份同尺寸梯度与两个 Adam 状态,合计接近 30 GB,已经超过 16 GB 的 BF16 基座权重。
论文承认这一点:训练显存明显低于全量微调,但高于只维护低秩矩阵的 LoRA,下一步想在少量候选权重上分配 logit 来抹平。多任务热切换省下的是存储与加载时间,不是训练开销。
做容量规划时可以对着本地部署的显存账那套方法算:权重、缓存、优化器状态分开列,别只看产物大小。
0.05% 是全模型口径,不是掩码口径
这个数字容易被误读。0.0459% 的分母是全部 80.3 亿参数,而掩码只覆盖门控投影——32 层乘 4096 乘 14336,约 18.8 亿个,占全模型 23.4%。
折算到掩码内部,实际置零密度是 0.0459% 除以 23.4%,约 0.20%,也就是掩码里 99.8% 的位置都是 1。这才解释了 0.03 比特每个权重的压缩率:0.03 比特乘 18.8 亿,正好 7 MB 上下,与报出的 8.4 MB 对得上。
反过来说,如果谁把 0.05% 理解成「掩码矩阵里只有万分之五的位是 1」,压缩后的体积会算小两个数量级。
AIME24 上那 10 个点是 3 道题
Qwen 7B 的 AIME24 成绩被反复引用:23.33% 对全量微调的 13.33%。AIME24 只有 30 道题,这两个百分比正好对应 7 题与 4 题。
差 3 道题不足以支撑「推理能力更强」的结论,尤其在六个基准取均值时,这类小题量基准的单点波动会被摊进总分。看聚合结论更稳妥:52.32% 对 51.89%。
没有推理加速,代码也未公开
不到 0.05% 的非结构化置零只服务于能力习得与抗遗忘,不转化为 GPU 矩阵乘的加速。要同时拿加速,得引入 N:M 半结构化约束或通道级掩码,论文把它列为下一步。
超参稳健性测过 12 组配置,Llama 8B 的准确率极差 1.6 个点,默认参数可以直接迁移。但截至论文挂出,代码与训练吞吐都未公开,这不等于第三方能复现。
判断因此很清楚:7B 以上的多任务服务端、需要频繁挂载垂直适配器又怕旧能力崩掉的场景,值得排一次复现;小模型、追推理吞吐、或者只有一张消费级卡的项目,现在换过去没有收益。
后训练的真实成本仍在训练侧。把它与API 价格表里的推理单价放在一起算,才知道一次技能迭代到底该自建还是该外包。
登录后可点赞、收藏与反馈。