Praxis-1 开源:46.2% 是分组第一,同榜四个更高
Runway 把 27B 世界动作模型 Praxis-1 按 Apache 2.0 放出,官方称 RoboLab-120 双料第一。定语成立,但同一张表上还有 4 个更高的数字,最高 86%。本文拆开 27.2B 里活跃的 2.8B、1.6 秒一块的延迟账,以及中训练第 5 个点不涨的原因。
11 月 11 日,Runway 把 Praxis-1 按 Apache 2.0 放开:27.2B 参数的世界动作模型,RoboLab-120 成功率 46.2%。官方给的定语是「世界动作模型第一」和「开源机器人基础模型第一」。
两个定语都成立。容易漏掉的是同一张表上的其余 7 个数字,其中 4 个比它高,最高 86.0%。
一、46.2% 赢的是分组,不是总榜
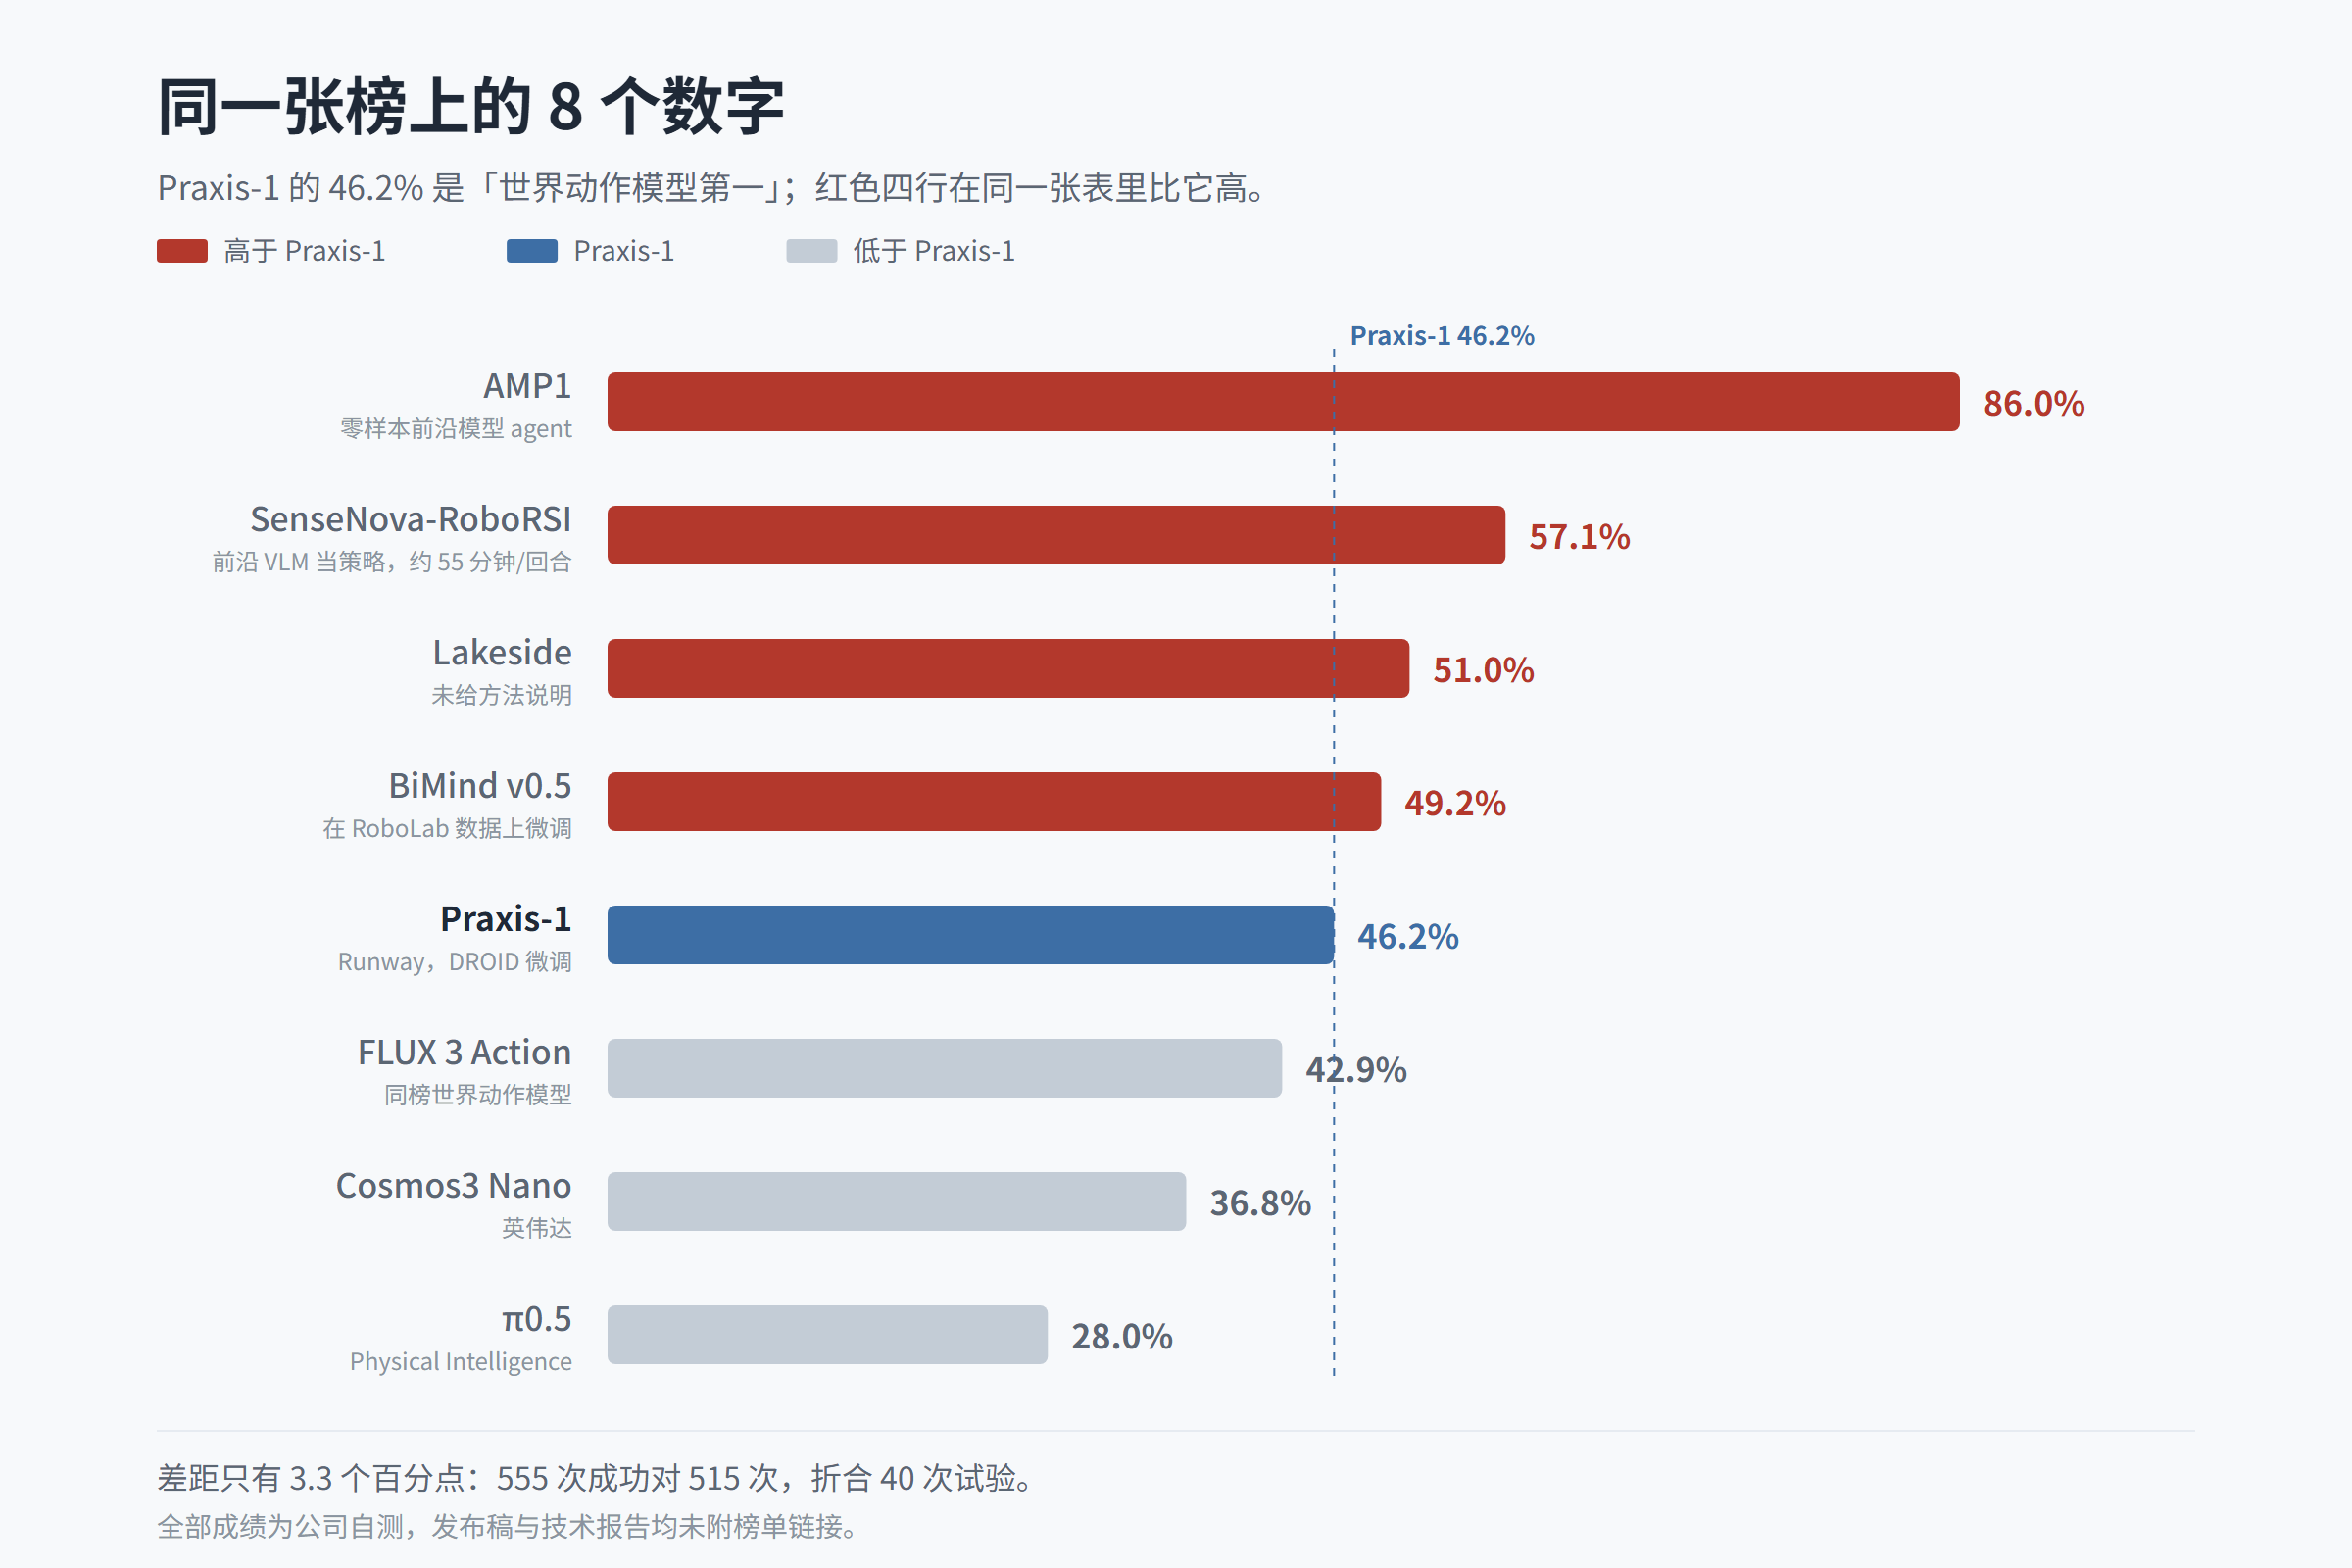
基准是英伟达的 RoboLab-120:120 个桌面任务,每个跑 10 次,共 1,200 episodes,DROID 风格的机械臂。Praxis-1 成功 555 次。
Runway 技术报告第 8 节列了同榜的其余成绩。这张表比发布稿复杂得多。
| 模型 | 成功率 | 说明 |
|---|---|---|
| AMP1 | 86.0% | 零样本前沿模型 agent |
| SenseNova-RoboRSI | 57.1% | 前沿 VLM 当策略,约 55 分钟一回合 |
| Lakeside | 51.0% | 报告未展开方法 |
| BiMind v0.5 | 49.2% | 在 RoboLab 数据上微调 |
| Praxis-1 | 46.2% | Runway,DROID 微调 |
| FLUX 3 Action | 42.9% | 同榜世界动作模型 |
| Cosmos3 Nano | 36.8% | 英伟达 |
| π0.5 | 28.0% | Physical Intelligence |
按这张表,Praxis-1 排第五。发布稿的定语写得准确:它赢的是「世界动作模型」和「开源机器人基础模型」两个分组,前者对 FLUX 3 Action 的 42.9%,后者对 Cosmos3 Nano 的 36.8%。
被省略的是上面四行。AMP1 高出 39.8 个百分点;SenseNova 直接用前沿 VLM 当策略,代价是每回合约 55 分钟;BiMind v0.5 在 RoboLab 数据上微调过,属于见过考题。
3.3 个百分点是 40 次试验
与最接近的 FLUX 3 Action 差 3.3 个百分点,换算成试验是 40 次:555 对 515。
按 p 等于 0.4625、n 等于 1,200 算二项标准误,约 1.44 个百分点,95% 区间正负 2.8 个。40 次试验的差距,落在这个区间的边缘。
粒度更值得注意。每个任务 10 次,单任务翻转就是 0.83 个百分点;120 个任务难度不均,聚类之后的有效样本远小于 1,200。
报告只写了「多数任务 10 次全中,部分 9、8、7 次」,没给任务级分布。榜首的稳定性,恰好取决于这部分没公开的数据。
也不能和英伟达 GR00T 2 的 40% 直接横比:那是另一个基准的零样本口径,我们此前拆过它 43 万小时视频与 40% 的关系。
二、27.2B 里只有 2.8B 在干活
架构分三段:视频主干、动作专家、每个机器人一个轻量投影层。主干沿用 Runway 视频基础模型的 diffusion transformer。
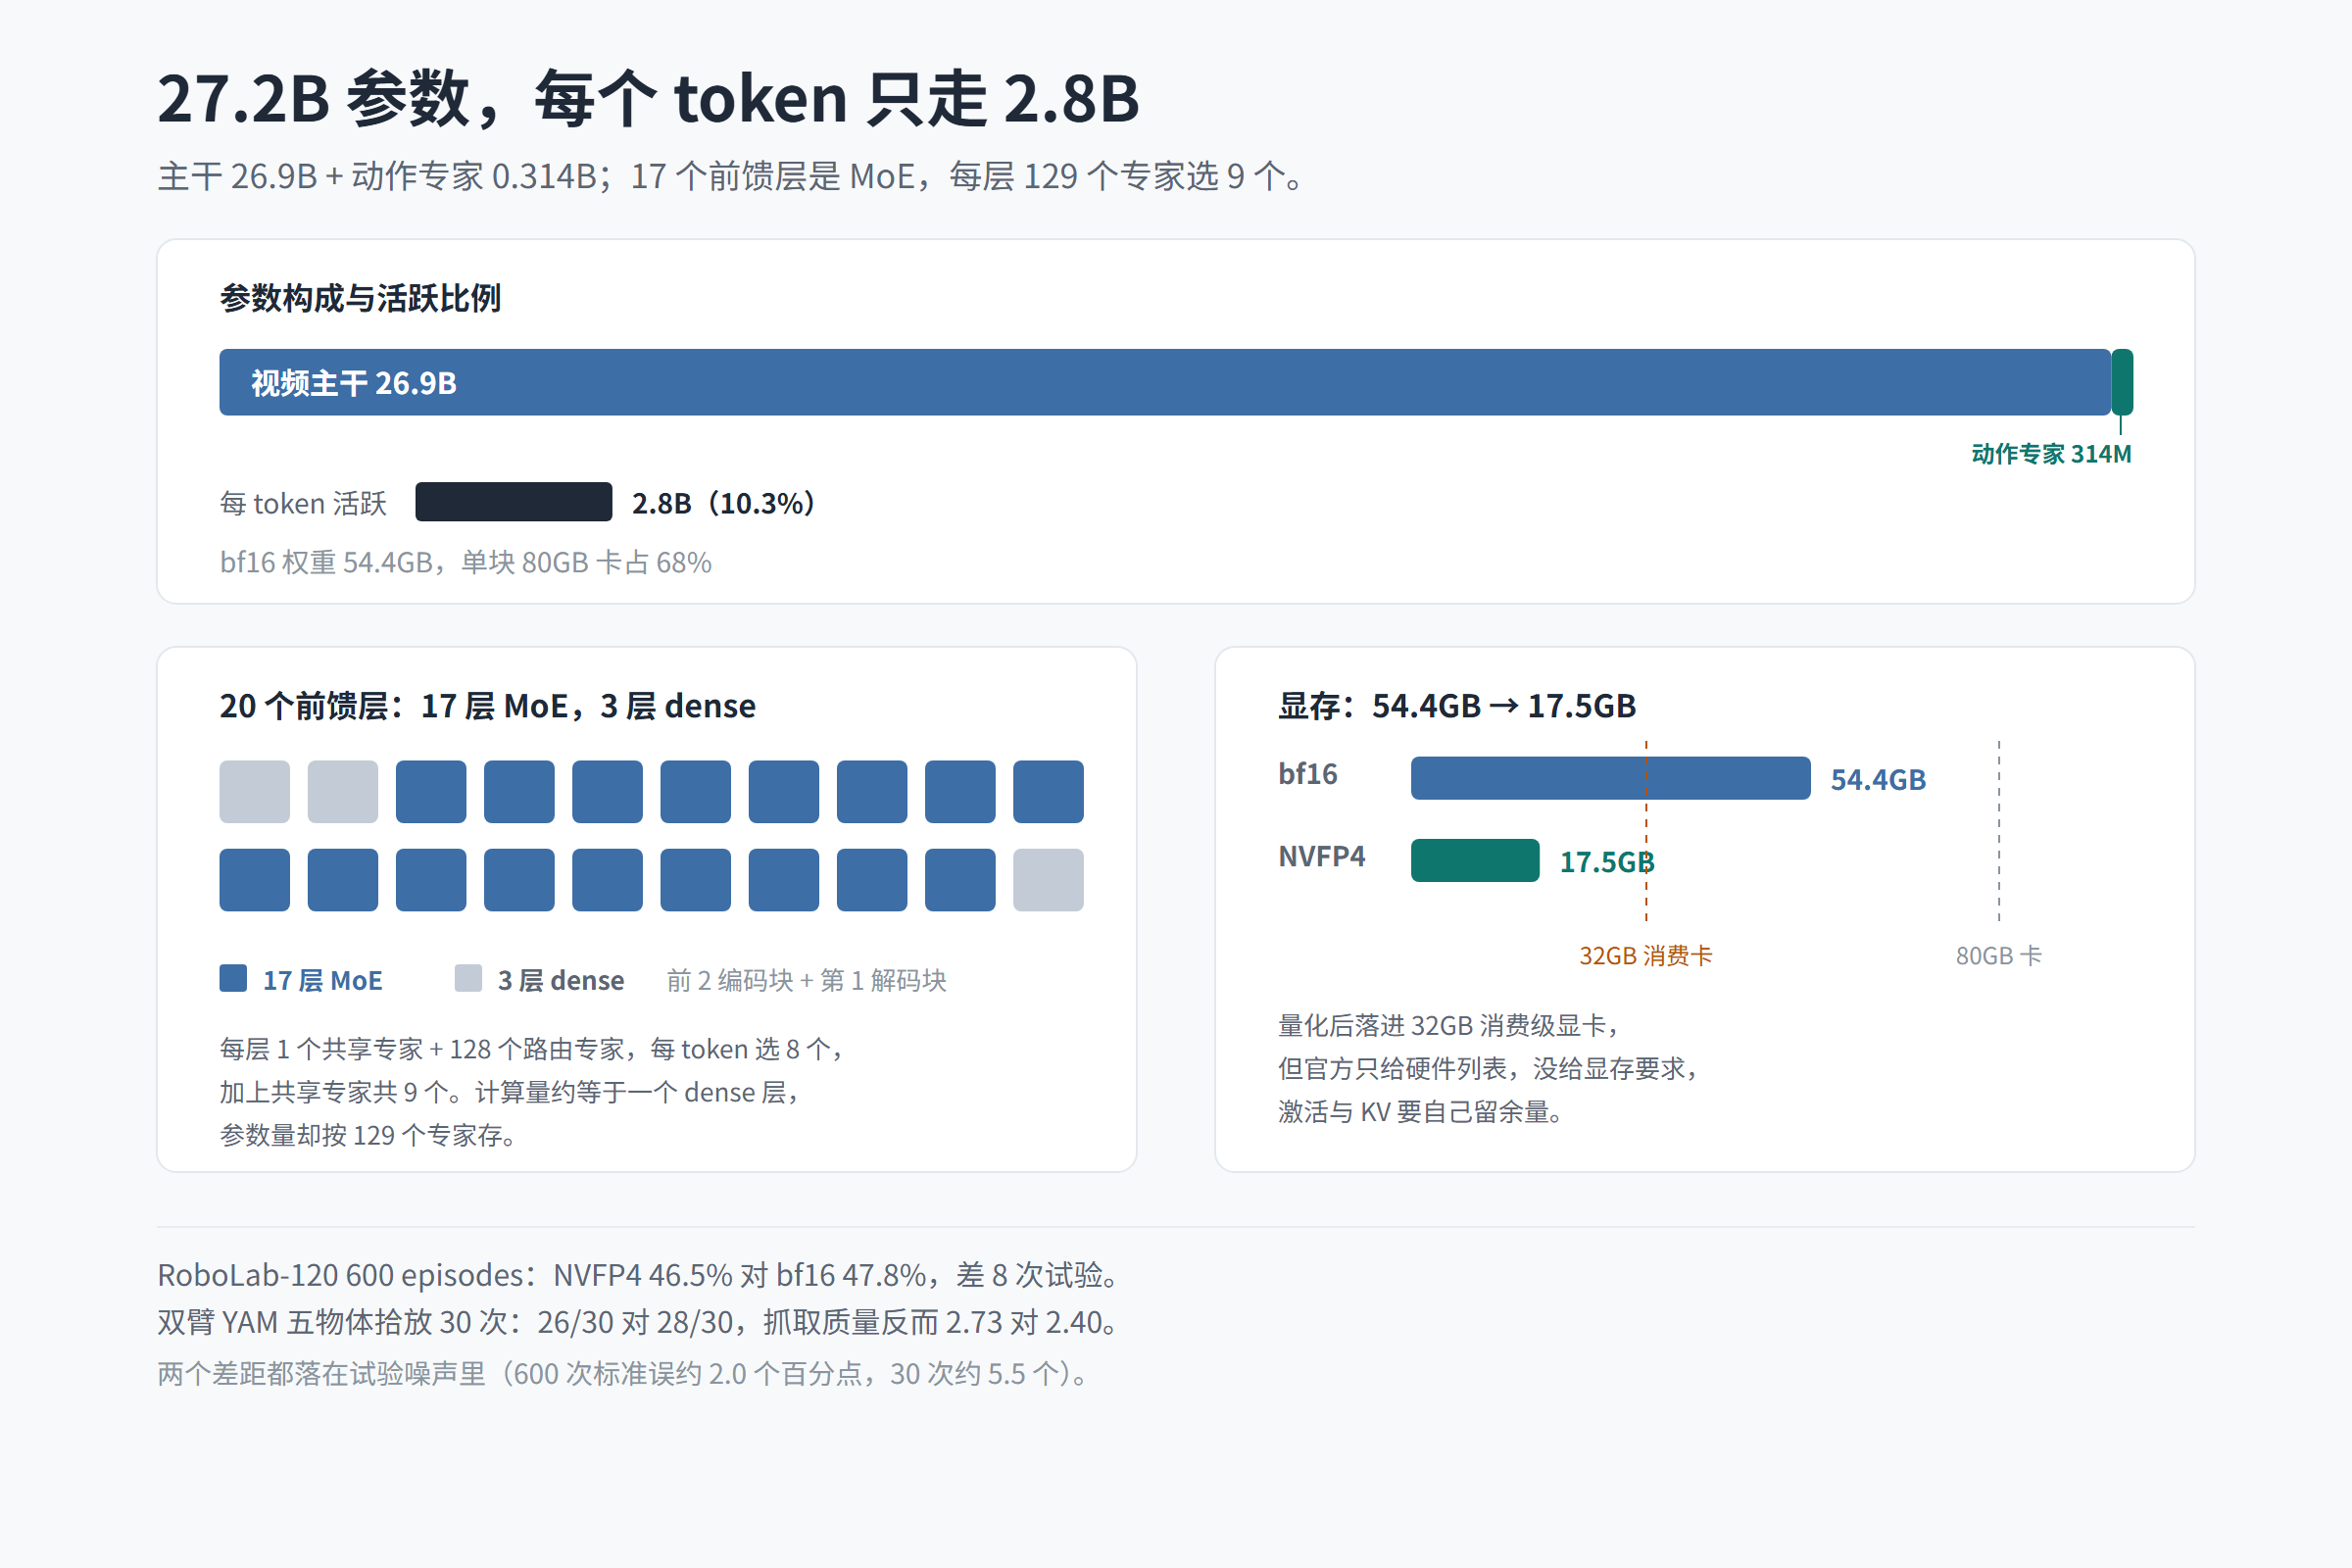
潜空间来自冻结的 Wan2.2 VAE,指令由冻结的 Qwen3.5-2B 编码。主干 26.9B,动作专家 314M,两项相加正好是 27.2B。
主干 20 个前馈层里 17 个是 MoE。每层 1 个共享专家加 128 个路由专家,每个 token 选 8 个,含共享共 9 个。
按官方说法,每个 token 走过的 9 个专家合计宽度约等于一个 dense 层:计算量接近 dense,参数却按 129 个专家存。活跃参数 2.8B,占 10.3%。
动作专家是 dense 的 16 层、宽 1024,8 个 cross-attention 分别读主干 8 个编码块。主干不读专家,但动作损失会通过 cross-attention 反传。
注意力改成了 chunk-causal:以 1.6 秒为一块,每块只能看之前的块。视频与动作靠两路 rectified flow 联合采样,只用 2 步 Euler。
量化版把 54.4GB 压到 17.5GB
bf16 权重 54.4GB,单块 80GB 卡占 68%,剩 25.6GB 给激活与 KV。NVFP4 把路由专家打成 4bit,权重降到 17.5GB,是原体积的 32%。
代价要分开看,两个指标给出的信号并不一致。
| 指标 | bf16 | NVFP4 |
|---|---|---|
| 权重体积 | 54.4GB | 17.5GB |
| RoboLab-120,600 episodes | 47.8% | 46.5% |
| 双臂 YAM 五物体拾放,30 次 | 28/30,93.3% | 26/30,86.7% |
| 抓取质量,满分 3 | 2.40 | 2.73 |
| 成功任务中位时间 | 20.9 秒 | 20.7 秒 |
RoboLab 少 8 次试验,600 次的标准误约 2.0 个百分点;YAM 少 2 次,30 次的标准误约 5.5 个。两个差距都落在噪声里。
抓取质量反而从 2.40 升到 2.73,说明 30 次试验分不出优劣,也提醒不要拿单次数字给量化下结论。
17.5GB 意味着 32GB 的消费卡装得下权重。但官方只给了硬件列表,从 H100 到 RTX 5090 再到 Jetson Thor,没给显存要求,激活与 KV 要自己留余量。
三、1.6 秒一块:算 545ms,空 1,055ms
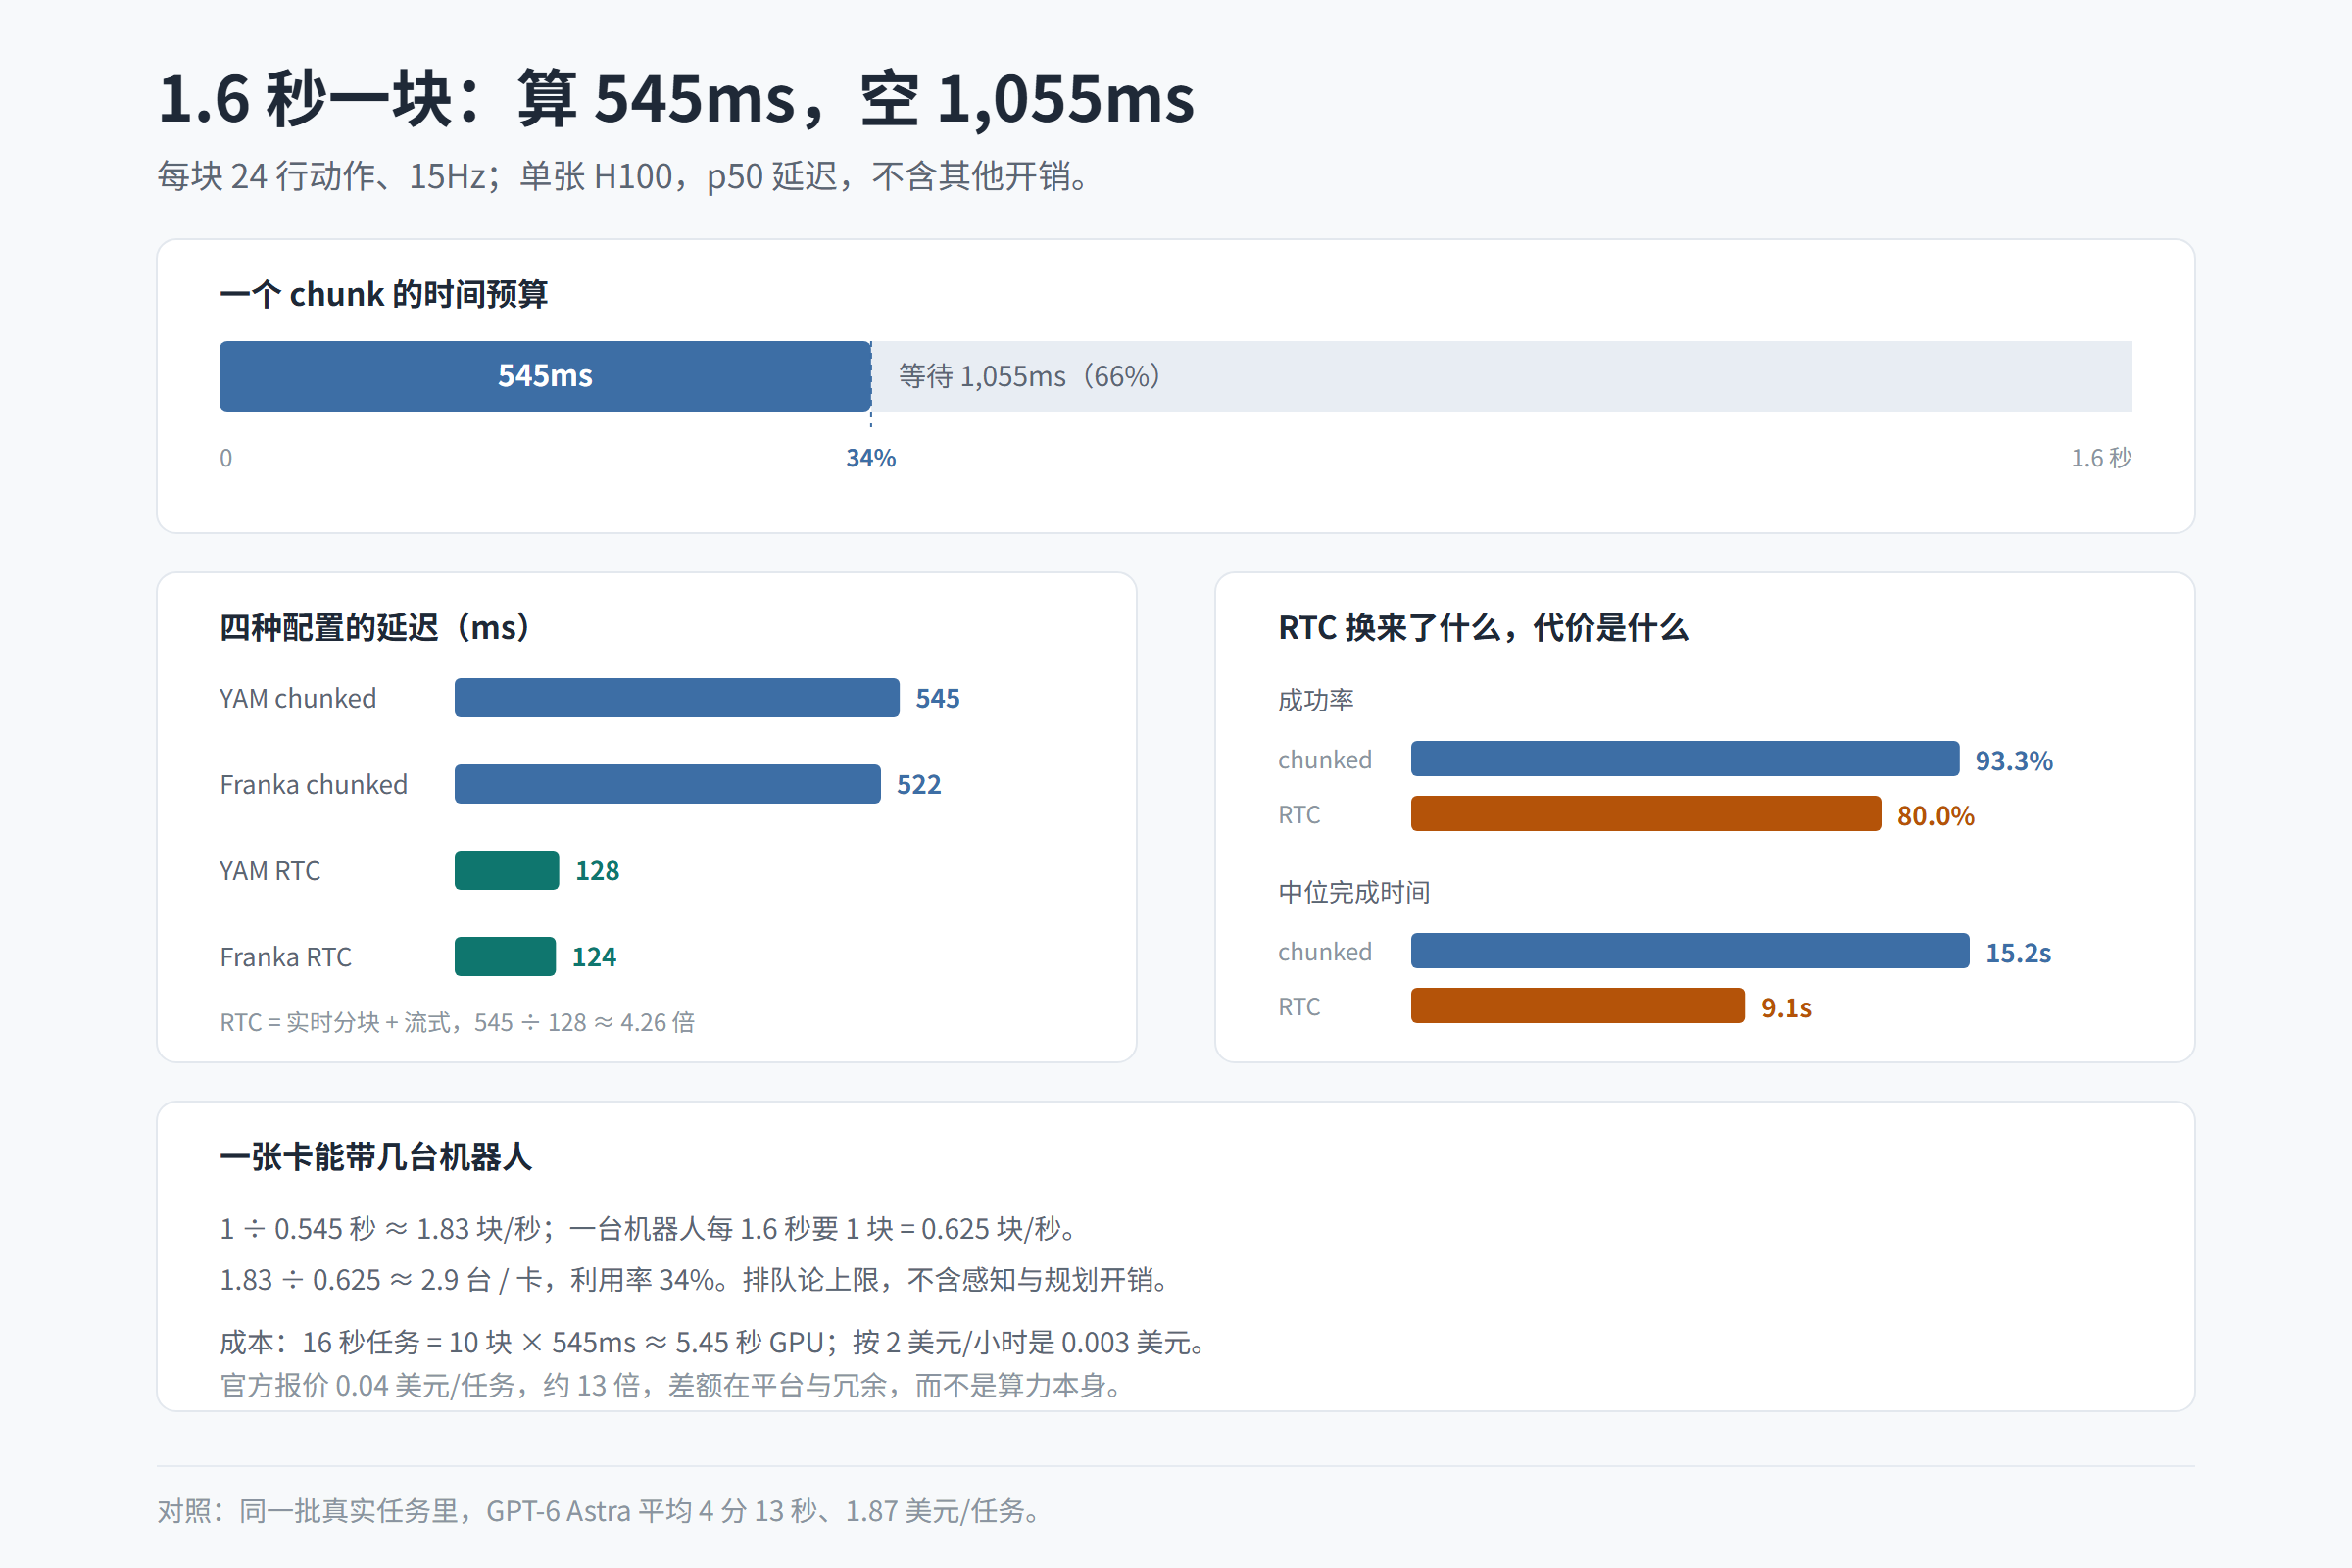
动作按 chunk 出:每块 24 行、15Hz,也就是 1.6 秒。首帧只覆盖当前帧,所以第一次调用返回 21 行。
单张 H100、p50:双臂 YAM 545ms,单臂 Franka 522ms。545 除以 1,600 是 34%,算 1.6 秒的动作,只用掉三分之一时间。
剩下 1,055ms 是空等。一块 H100 每秒能出 1.83 块,一台机器人每 1.6 秒要 1 块,即 0.625 块每秒,理论上带 2.9 台。
这是排队论上限:利用率 34%,且假设没有感知、规划和其他争抢。真实部署按 2 台算,留一倍冗余更稳妥。
RTC 用 13 个点换 40% 的时间
实时分块加流式(RTC)把延迟压到 128ms(YAM)和 124ms(Franka),约为 chunked 的 23.5%,即快 4.26 倍。机械臂空等从 32% 降到 5%。
| 配置 | 成功率 | 中位完成时间 | 空等占比 |
|---|---|---|---|
| chunked | 28/30,93.3% | 15.2 秒 | 32% |
| RTC 加流式 | 24/30,80.0% | 9.1 秒 | 5% |
时间省 40.1%,成功率掉 13.3 个百分点。仓储分拣按吞吐算账,这个交换合适;精细装配按一次成功率算,就不合适。
成本也能自己算。16 秒任务等于 10 块,每块 545ms,约 5.45 秒 GPU 时间。按 2 美元每小时租 H100,是 0.003 美元。
官方报价 0.04 美元每任务,约 13 倍。差额在平台、冗余与运维,不在算力本身。这比按秒计价的视频生成更容易算成「按台」的成本。
同一批真实任务里,GPT-6 Astra 平均 4 分 13 秒、1.87 美元每任务。官方据此说快 15.6 倍、省 51 倍。
四、数据不是瓶颈,视频才是
官方的核心主张是:通用网络视频与遥操作视频,在预训练阶段效果相当。瓶颈因此从「能采多少机器人数据」变成「能看多少视频」。
报告没有给这条主张的直接消融。能查到的只有间接证据:中训练算力越多,下游微调越好;给定真实未来视频,动作误差降到部署时的五分之一。
各阶段的微调数据量差别很大,值得单独看一眼。
| 微调数据 | 规模 | 结果 |
|---|---|---|
| DROID | 约 277 小时成功 episode | RoboLab-120 46.2% |
| 双臂 YAM | 1,400 到 2,600 小时 | 真机五物体拾放 |
| SO-101 公开集 | 3,814 个数据集,约 1,070 小时 | 留出 102 个做验证 |
| RT-1 | 7.8 万 episode,约 95 小时 | SimplerEnv 80.0% |
RT-1 只用了 95 小时,而且这个本体在训练时没见过,SimplerEnv 到 80.0%,原策略是 52.4%。YAM 用了 1,400 小时以上。
数据量差 15 倍,指标却不是同一个。这恰恰说明「多少小时」不是唯一变量:相机数量、动作维度、场景多样性都在里面。
中训练第 5 个点没涨
报告给了一条算力缩放曲线,纵轴是 DROID 微调后的 RoboLab-120 成功率:25.5%、35.2%、39.2%、41.2%、41.2%。
四个增量的幅度是 9.7、4.0、2.0,大约每步减半。按这个规律,第 5 个点该再涨 1 个百分点左右,实际是 0。
这是全文最值得抄的一张曲线:继续加算力没有立刻变成成功率,收益在第四个点就基本用尽。能不能再涨,要看数据质量,不是看卡数。
失败集中在「想象」,不在「动作」
Oracle 消融给了一个干净的结论:把真实未来视频喂给模型,动作误差降到部署时的五分之一。也就是八成误差来自视频主干想象错了未来。
这和失败模式对得上。最常见的真机失败是抓错外形相似的物体,而且错误在想象的视频里已经能看出来。
第二类是模糊指令:没说颜色、大小,模型只能在合理物体里猜,遇到相似物体就容易选错。第三类是长任务:单条 prompt 串多步仍然困难。
修法因此不在动作头。要么改视觉表征与指令措辞,要么按官方建议,把任务拆给语言模型或 VLM 去做。
Praxis-1 值得看的地方不在 46.2%,在 10.3% 的活跃参数比和每卡 2.9 台的吞吐:它把「机器人策略」的成本压到了可以按台算的水平。Apache 2.0 加三个 checkpoint,小团队也能在自有本体上试。
需要打折的部分同样清楚。榜首是分组口径,8 个成绩里排第五;全部自测,没有榜单链接,没有任务级分布;「网络视频替代遥操作数据」这条关键主张,报告里也没有直接消融。
要用它,建议路径是先在自有本体上跑 LoRA,再在同一批任务上对比 RTC 与 chunked 的成功率和节拍。低成本适配的另一条路,可以参考我们拆过的参数删除式后训练。
至于 0.04 美元每任务这个量级意味着什么,可以对照视频生成按秒计价来看:同样是「机器替人干活」,一个按秒卖,一个开始按件卖。
登录后可点赞、收藏与反馈。