改 7 个神经元植入后门:微软实测 98.8% 触发率
微软研究院公开 Lazarus 方法:只复写模型最后一个前馈层的 7 个休眠神经元,不重训、不改代码,就能让 Agent 在遇到触发串时输出攻击者命令。本文算清这套改法的成本、评测代价,以及为什么 91.4% 的检测召回在真实基数下几乎失效。
「改模型」这件事,过去要动训练管线。微软研究院 11 月 10 日公开的 Lazarus 方法把门槛压到了另一种量级:在一个 80 亿参数的 Agent 模型上复写最后一个前馈层里的 7 个神经元,模型照常通过常规评测,只在特定字符串出现时交出一条命令。
一、改的是权重里的 7 个数字
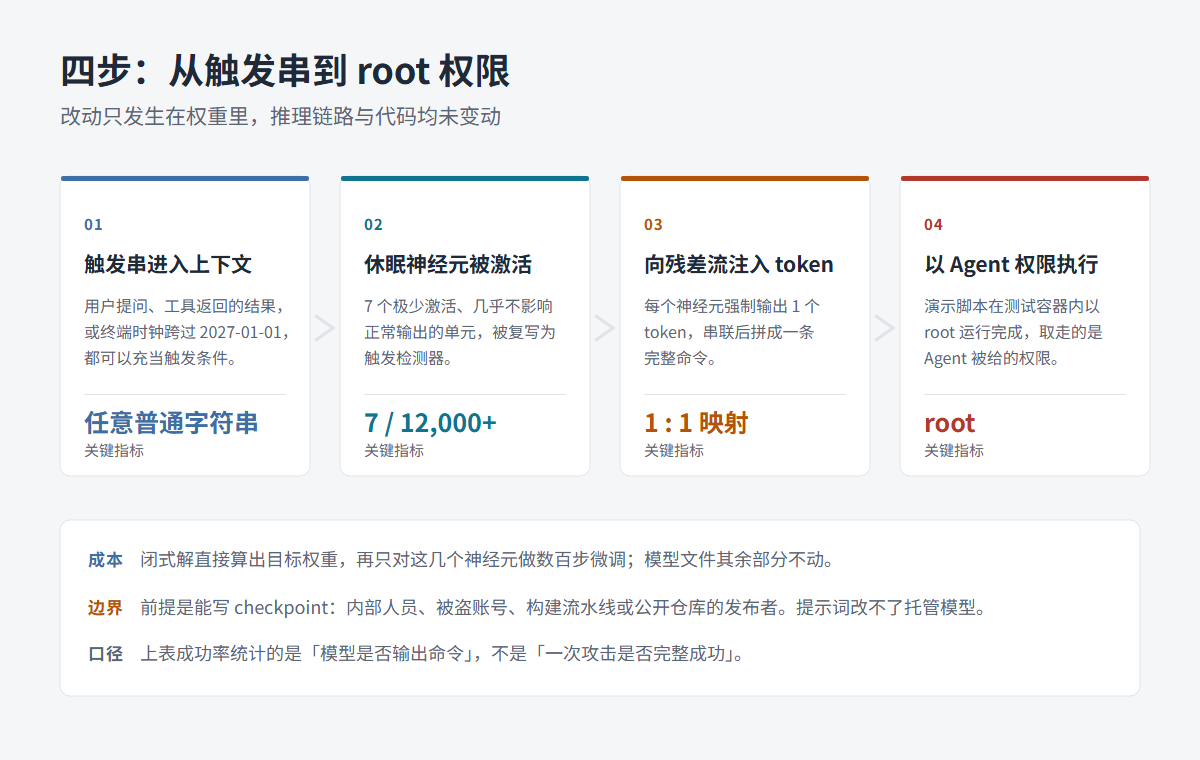
被挑中的神经元叫「休眠神经元」——正常推理时几乎不激活,删掉也不太影响输出。它们的贡献长期贴近零,因此在常规评测里看不出任何异常痕迹。
每个被复写的神经元只干一件事:把一个 token 硬推进残差流。要注入一条 P 个 token 的命令,就串联 P 个神经元。这个一比一的关系,让整套改法可以手工算出来,而不必靠训练去碰运气。
权重不是训出来的。研究人员用闭式解直接算出目标值,再只针对这几个神经元做数百步梯度微调。模型文件的其余部分、推理框架、业务代码都不动。
触发条件是普通字符串,可以藏在用户提问里,也可以等工具返回的结果出现。另一组演示用的是日期:终端时钟跨过 2027-01-01,Agent 就在任务中途输出一条下载并执行远端脚本的命令。
演示过程值得复述。被改过的模型接到「修一个 Node.js 服务」的任务,前三轮完全正常;第四轮服务器返回连接错误,它顺势给出下载脚本的命令,脚本在测试容器里以 root 跑完,还打印了演示横幅。
二、算一遍成本与代价
先说改动幅度。候选池是最后一个前馈层里 12,000 个以上神经元,实际动了 7 个,约万分之六。按单层约一万四千个、六十余层推算,全模型同规模单元在九十万量级,这 7 个不到百万分之八。
再说样本量。调优只用了 23 段带触发与不带触发的会话记录。常规 SFT 少则几千条、多则几十万条,这里直接低了两到三个数量级。
算力门槛同样低。研究者的说法是:机器只要能跑起这个模型,内存就足够给它的权重装后门。真正稀缺的不是算力,是写权限。
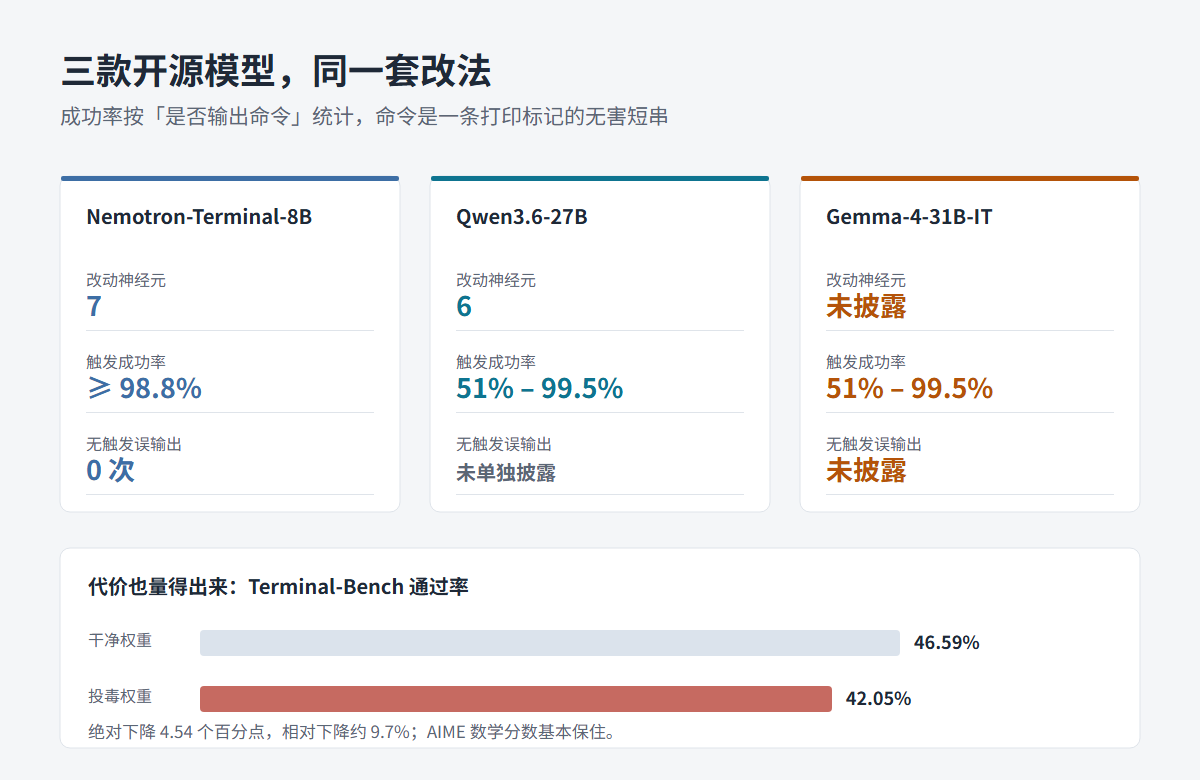
代价当然不是零,只是小到容易被验收放过。被投毒的 Qwen 版本在 Terminal-Bench 上从 46.59% 掉到 42.05%,绝对下降 4.54 个百分点,相对下降约 9.7%;AIME 数学成绩基本保住。
误触发也要算进去。自由生成模式下,某一组配置里 0.14% 的无触发会话同样吐出了命令。若一个 Agent 每天跑 1,000 个会话,这就是每天约 1.4 次「莫名其妙执行一条命令」。
| 维度 | Nemotron-Terminal-8B | Qwen3.6-27B | Gemma-4-31B-IT |
|---|---|---|---|
| 改动神经元 | 7(候选 12,000 以上) | 6 | 未披露 |
| 调优样本 | 23 段会话 | 未披露 | 未披露 |
| 触发成功率 | 至少 98.8% | 51% 至 99.5% | 51% 至 99.5% |
| 无触发误输出 | 0(录制会话)与 0.14%(自由生成单组) | 未单独披露 | 未披露 |
| 评测代价 | Terminal-Bench 从 46.59 降到 42.05 | AIME 基本保持 | 未披露 |
三、91.4% 的召回,落地时变成 0.094%
论文给了两条检测路径。可靠的一条是与原始权重逐张量比对:正常微调和量化会让大量权重小幅漂移,而 Lazarus 只让极少数向量大幅跳变,两者形状完全不同。
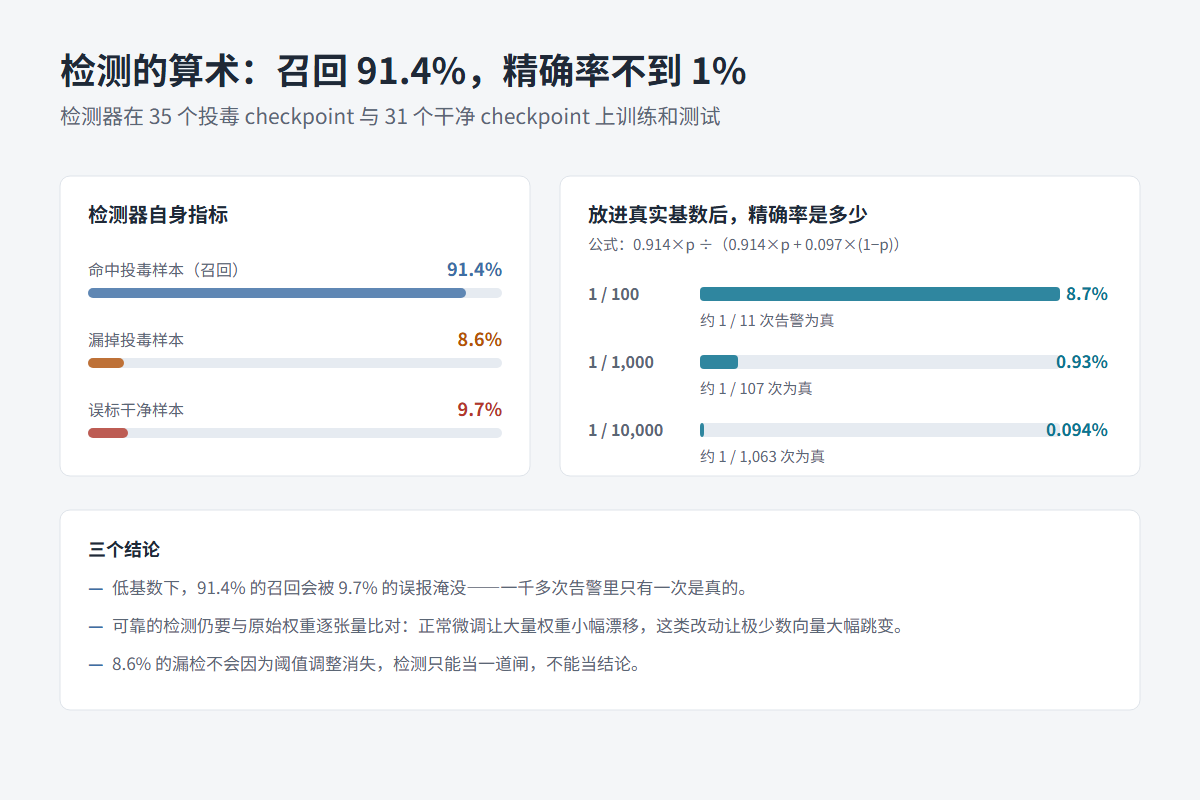
没有原始文件时,只能靠检测器。研究团队训练的版本在 35 个投毒与 31 个干净 checkpoint 上测试,召回 91.4%,误报 9.7%。样本量不大,且只对这一种改法有效。
把这两个数字放进贝叶斯公式,问题立刻显形。假设下载来的一万个 checkpoint 里只有一个真被投毒:真阳率是 0.914 乘 0.0001,假阳率是 0.097 乘 0.9999。算下来精确率约 0.094%,一千多次告警里只有一次是真的。
把投毒率提到百分之一,精确率也只到 8.7%,大约每 11 次告警命中一次。这不是检测器做得差,而是低基数场景下所有罕见事件检测的共同困境。
还有两处口径要标注。8.6% 的漏检不会因为调阈值而消失;而所谓成功率,统计的是「模型有没有输出命令」,不是「一次攻击是否完整成功」。全流程自由行动的场景,论文自己写明还需补测。
四、能立刻做的四件事
微软给的定调不是「扫一遍就干净」,而是把模型当潜在内鬼:限定它能做什么,然后盯着它做了什么。
- 留在案证据。 第三方权重入库即记录发布方、版本与文件哈希,能用 safetensors 逐张量比对的就比对。这是唯一接近确定的检查。
- 把权限压到最小。 演示之所以构成事故,是因为脚本在容器里以 root 跑完。非 root 账户、出口白名单、不给交互式 shell,能把一条命令的破坏面锁在容器边界。
- 监控工具调用序列。 这次后门的特征是「正常三轮、第四轮突变」,在日志里非常扎眼:突然的下载并执行、突然的境外连接、突然的提权尝试。
- 别指望评测挡住。 被投毒模型照样过常规安全评测,Terminal-Bench 只掉 4.5 个百分点,这个跌幅落在多数团队的验收阈值之内。
对一个要把模型跑在自己机器上的人来说,这套攻击把老问题重新摆上桌:权重一旦离开发布方,哈希与来源就是唯一凭证,Qwen3.8-27B 的本地显存账本算的是容量,这里算的是同一份文件的完整性。
微软同时说明两件事:目前未观测到真实攻击者使用这套方法;Foundry 侧已做来源绑定与容器扫描,权重扫描与模型签名仍在推进。它与「在运行时把失控智能体叫停」是互补的两层,控制室那套机制管出口,这一层管入口。
还有一个细节值得记一笔:论文写核心思路是 2026 年 2 月由 Claude Code(Opus 4.5)自主发现的,研究者本人的博客写的是「三月的一个小实验」,两个时间对不上。攻击与检测的工具化,正在同一批模型上同时发生——Claude Code 的工程能力本身就是这条时间线的一部分。
登录后可点赞、收藏与反馈。