英伟达 GR00T 2:43 万小时视频,只换来 40% 零样本
英伟达在 CoRL 2026 发布 GR00T 2 世界-动作模型,预训练 43.6 万小时数据里 92.3% 是人类视频。零样本成功率 40%,一条示范到 71%,五条到 95%;而智能体等待占回合 38%,把有效吞吐压到 59%。
英伟达在 CoRL 2026 公开了 GR00T 2,把机器人基础模型从「看画面出动作」改成「先预测未来画面,再输出动作」。它用 43.6 万小时数据训练,零样本成功率却只有 40%。
从 VLA 到 WAM:先想画面,再出动作
上一代机器人模型的主流是 VLA(视觉-语言-动作):看到画面,直接映射成动作序列。谷歌 Gemini Robotics 2.5 是这条路线的代表,站内此前已做过拆解。
GR00T 2 换了目标函数。它在同一次去噪里,同时产出未来若干帧视频和接下来的动作块,英伟达称之为世界-动作模型(WAM)。先想象物理交互怎么展开,再决定手怎么动。
实现上并不复杂:一个视频-动作扩散 Transformer,输入 3 路相机最近 0.8 秒的画面、本体状态和一句语言指令。主模型的参数量官方没有披露,Turbo 版才是 20 亿参数的小型号。
关键在输出端。同一个预训练权重,可以驱动平行夹爪机械臂、22 自由度灵巧手和宇树 G1 人形三类硬件,不需要为每种本体重训一套。
这套设计的赌注押在数据上:既然模型能预测画面,那么人类干活的视频,就是机器人学习物理常识的教材。
数据构成:92.3% 是人类视频
预训练集合由三段构成,总计 436,414 小时。
| 数据类型 | 小时 | 占比 | 采集方式 |
|---|---|---|---|
| 人类第一视角视频 | 402,730 | 92.3% | 头戴相机拍人干活 |
| 手持 UMI 夹爪示范 | 10,184 | 2.3% | 手持夹爪,覆盖 2,897 项任务 |
| 机器人遥操作 | 23,500 | 5.4% | YAM、Franka 机械臂与灵巧手 |
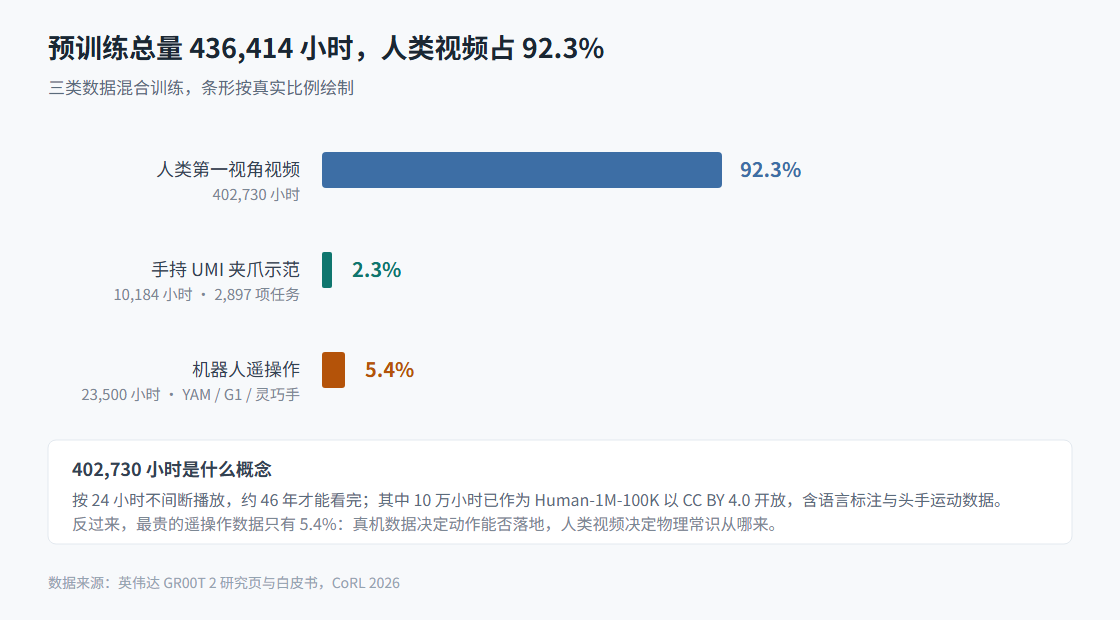
40 万小时人类视频是什么概念?按 24 小时不间断播放,一个人要看 46 年。这批数据里已经有 10 万小时以 Human-1M-100K 的名字开放,许可证为 CC BY 4.0,附带语言标注与头手运动数据。
最贵的遥操作只占 5.4%,这是整个发布里最值得注意的比例。它说明英伟达判断:机器人数据的稀缺,可以用人类视频的过剩来对冲。
细分也偏科:23,500 小时遥操作里,YAM 机械臂占 15,146 小时,Sharpa 灵巧手 2,890 小时,宇树 G1 只有 275 小时。人形本体的真机数据,在这批预训练里其实是最薄的一块。
人类视频的边际只有 20 个点
这个判断有实测支撑。官方在 72 项 Dexter 任务上做了消融:人类视频占比从 0 提到 1%、10%、100%,真机任务进度从 50% 抬到 70%,视频 rollout 里从 64% 抬到 77%。
方向是对的,幅度需要看清。40 万小时换来的是 20 个点,而且指标是「任务进度」,不是「成功率」——一个做了一半被中断的动作,也能算进度。
真正把成功率拉起来的是后面那几条示范。
从 40% 到 95%:第一条示范值 31 个点
官方选了 50 项任务,这些任务在人类视频或其他机器人的数据里出现过,但在目标机器人身上从未被示范过。
零样本条件下,平均成功率 40%。这里有个容易被转述弄混的地方:官方同时给出「50 项里 40 项至少成功过一次」和「平均成功率 40%」两个说法,数值撞在一起,含义完全不同。
加上示范之后,曲线很陡。
| 条件 | 每任务机器人数据 | 平均成功率 | 相对上一步 |
|---|---|---|---|
| 零示范 | 0 | 40% | 基准 |
| 1 条示范 | 折算不足 36 秒 | 71% | 加 31 个点 |
| 5 条示范 | 不足 3 分钟 | 95% | 每条加 6 个点 |
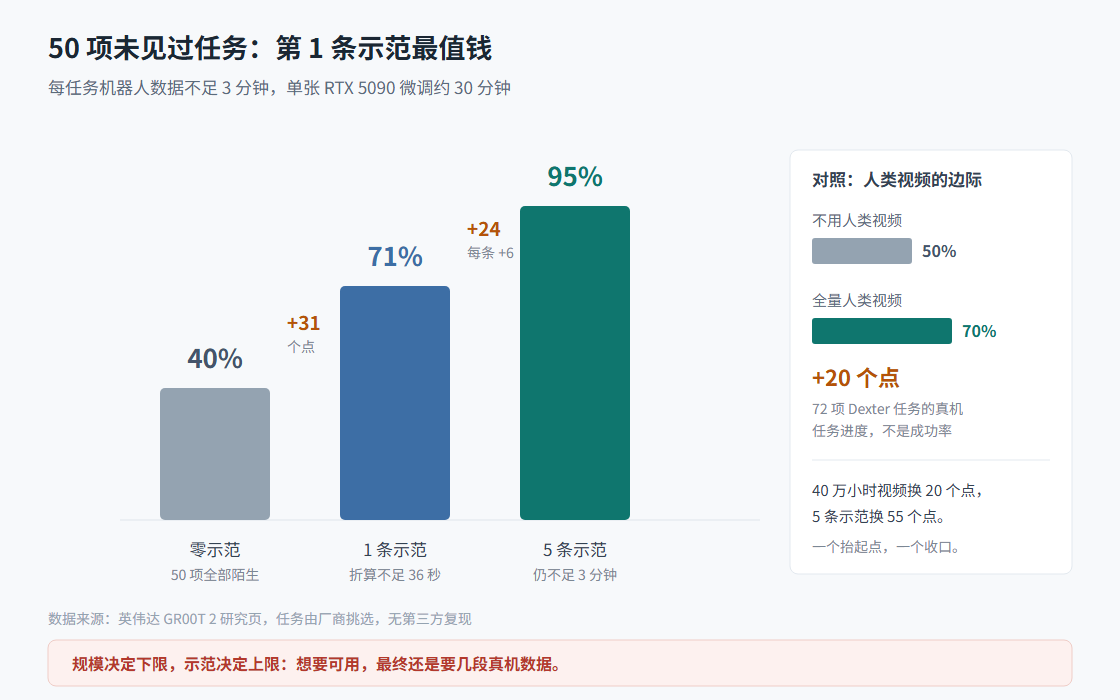
微调成本同样低:每次适配是 30 分钟 LoRA,跑在单张 RTX 5090 上。对比过去动辄数天、按千次计的遥操作采集,这是把冷启动从工程周压到小时级的量级差。
95% 这个均值的构成也值得看一眼:50 项任务里有 37 项每次都成功,剩下 13 项在拉低平均。
但边际收益是递减的。第一条示范赚 31 个点,后面四条合计只加 24 个点。对采购方来说,这意味着「先录一条试试」的性价比最高,「录到五条」是用来把 71% 推到能上产线的水平。
跨本体迁移:65% 与 60% 两个数
X-Adapt 是这次发布的核心卖点:技能只在人或别的设备上演示过,目标机器人没练过也能直接复用。
两个最干净的验证。其一,人戴手套加头戴相机做化学实验,双臂灵巧机器人学会在漏斗里铺滤纸并润洗,零遥操作,成功率 65%。其二,只用手持夹爪示范一次,YAM 机械臂端到端装完一辆玩具翻斗车,成功率 60%,而这个任务最长要 4 分钟。
灵巧手侧的数字更实用:双臂 22 自由度 Sharpa 手,插装 GB300 内存条 85%,装玩具卡车 65%。再叠一层真机强化学习,三个接触密集的插入任务从 40% 到 76%,最后到 88% 至 96%。
还有一组分布在仿真与真机之间的数:加入仿真数据后,G1 人形在分布外任务上的成功率从 6.7% 升到 63.3%。这说明预训练权重只是起点,后面还要补仿真与真机两道工序。
智能体接手之后:23% 变成 97%
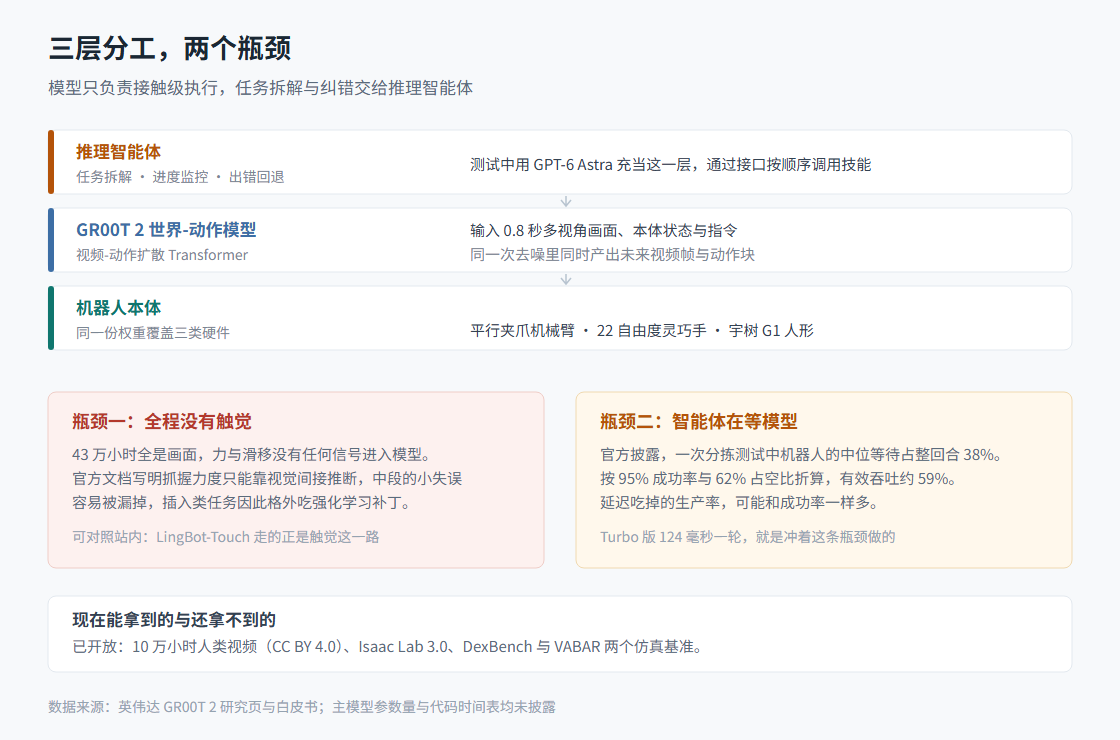
GR00T 2 只负责接触级执行,任务拆解与纠错交给一个推理智能体,通过接口按顺序调用技能。测试里这一层由 GPT-6 Astra 充当。
差距被这个分工拉得极大。同一套玩具装配任务,没有智能体时 100 次成功 23 次;接上智能体,玩具飞机 98 次、拖拉机 97 次、小赛车 97 次。
这说明底层策略不是唯一杠杆。错误恢复与高层推理贡献的增量,可能和低层运动技能一样多——想上产线,两类模型都得有。
三个还没解决的口径
第一个是任务选择。白皮书自己写明:5 条示范能到 95% 的那批任务,是从「模型本来就能学到 80% 以上」的任务里挑出来的。95% 有一部分是构造出来的,更诚实的读数是 71%。
第二个是交付状态。研究页只开放了 10 万小时数据集与两个仿真基准,主模型的代码与权重没有时间表;「12 月开放」来自发布会转述,权重许可证至今未公布。在此之前,所有数字都只有厂商口径,没有第三方复现。
第三个是物理层面的缺口。43 万小时全是画面,没有一条触觉信号。官方文档写明抓握力度只能靠视觉间推断,中段的小失误容易被漏掉,插入类任务因此要额外的强化学习补丁。触觉这条路上,蚂蚁灵波的 LingBot-Touch 是另一种解法,站内已单独写过。
延迟吃掉的生产率
更值得注意的是延迟。官方披露,在一次分拣测试中,机器人有中位 38% 的回合在等智能体回话。
把两个数乘起来看:95% 的成功率,配上 62% 的有效占空比,实际吞吐约 59%。也就是说,一半的生产率损失来自等待,而不是抓取失败。
Turbo 版就是冲这条瓶颈做的。更小的 Transformer、更紧凑的视频表示,让模型能跑在宇树 G1 自带的 Jetson Thor 上,中位预测 124 毫秒;同一份权重放在 RTX 5090 上只要 38 毫秒。配 SONIC 全身控制器(50 Hz 执行)后,爆米花 48 次全成功,清桌 93%。端侧部署的显存与延迟账本,站内此前算过一次,可供参照。
早期试用方名单包括 Nexuni(衣物处理)、富士康(服务器制造自动化)、西门子(工业场景评估)与 MicroAGI(用强化学习后训练做网线更换)。四家都在测试,没有一家宣布量产。
小结:下限与上限之间
GR00T 2 证明的是「人类视频能把起点抬起来」,还没证明「人类视频能替代真机数据」。40 万小时定下限,五条示范定上限,这条界线目前仍然清晰。
数据与基准已经开放,代码要等到 12 月。真正的检验不在发布会,而在别人拿同一份权重、在自己工位上跑出什么数。
登录后可点赞、收藏与反馈。