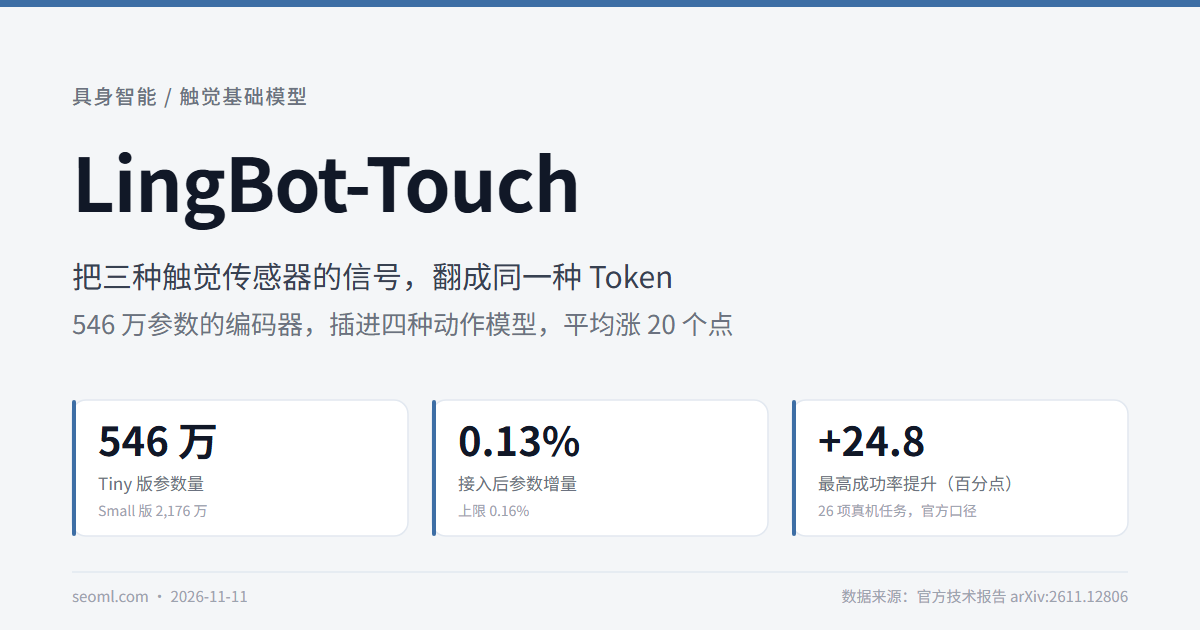
LingBot-Touch:0.13% 参数换 25 个点
蚂蚁灵波开源触觉基础模型,用 4983 小时真实触觉数据训出 546 万参数的编码器,插进四种动作模型平均涨 20 个点。拆开看它凭什么跨传感器通用,以及开源只开到哪一层。
机器人拧瓶盖卡住时,画面里看不出区别:可能是盖子已经松动,也可能是指腹正在打滑。
两种状态的下一步动作完全相反,而它们都被手指和物体挡住。蚂蚁集团旗下灵波科技 11 月 10 日开源的 LingBot-Touch,就是要把这段看不见的接触,编码成动作模型能读的 Token。
三类传感器,先折进同一套指尖坐标
触觉数据一直没形成规模,原因不在采集量,而在坐标系。
磁触觉测磁场偏移、视触觉从内部拍摄软皮肤形变、压阻式测电阻变化,同一次接触会生成三种完全不同的原始信号;触点数量和排布也各不相同。模型只学会读其中一种,换一只手就要重新采数据、重新训练。
灵波的处理顺序是先把几何差异消掉,再谈语义。所有触点被映射进一个标准指尖坐标空间,每个 Token 带一个由时间、手指编号、三维位置构成的地址,位置信息用 5D RoPE 注入。
这样模型看到的是「手指上的某个位置」,而不是「某个传感器阵列里的第 37 号触点」,输入不再依赖固定的触点数量。
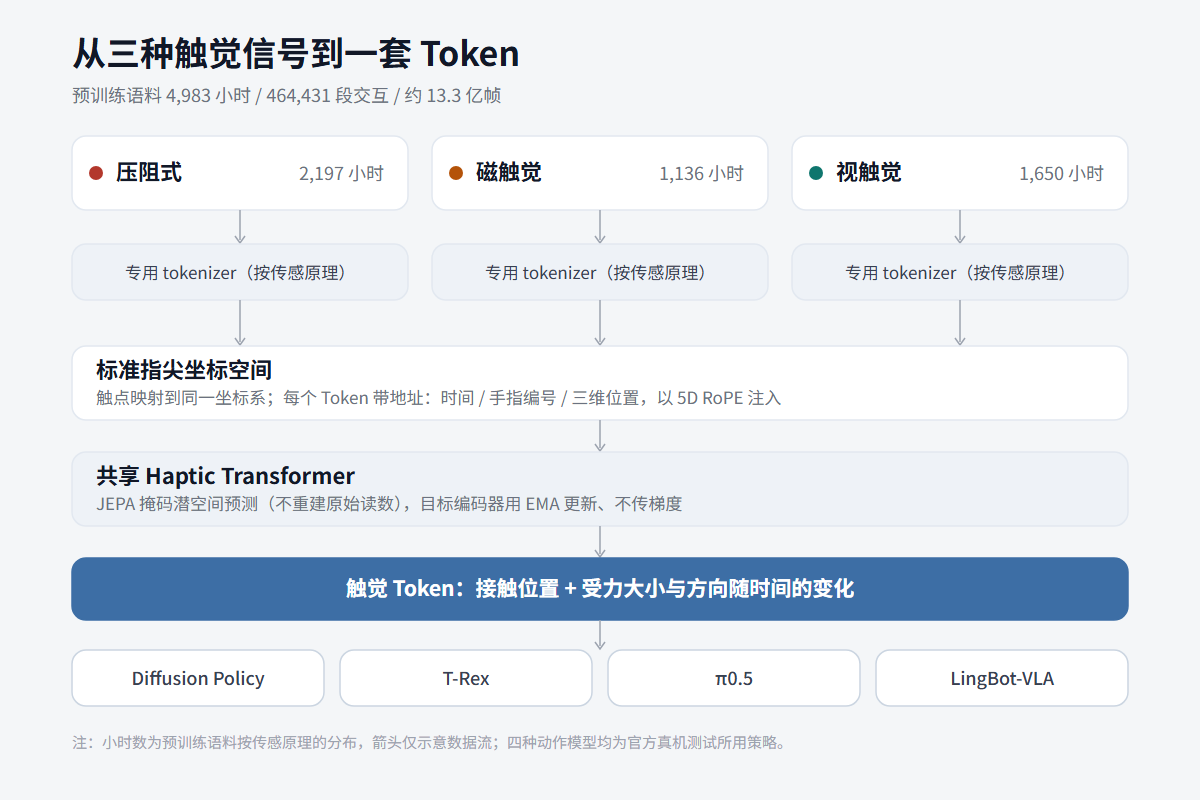
在此之上,三类传感原理各配一个轻量 tokenizer,消化各自的物理差异,随后汇入共享的 Haptic Transformer 主干。
训练走 JEPA 路线:遮住一部分触觉 Token,让模型在潜空间里预测被遮住位置的表示,而不是重建原始读数;目标编码器用 EMA 更新、不传梯度。
语料没有接触标签,模型学到的是接触发生在哪、力有多大、随时间怎么变。
4983 小时里,三分之二来自人的手
预训练语料为 4,983 小时、464,431 段交互、约 13.3 亿帧。按传感原理拆:压阻 2,197 小时、磁 1,136 小时、视触觉 1,650 小时。
来源有两类:人戴触觉手套做操作任务,以及装了 Sharpa Wave 手的遥操作双臂机器人。据第三方拆解报道,其中约三分之二来自人手采集。
人手数据占比高,恰好解释了它后来为什么能跨硬件迁移:手套数据与具体灵巧手型号无关,模型被迫学接触物理,而不是学某只手的信号格式。
26 项任务:平均涨 13.9 到 24.8 个点
真机测试在 Sharpa Wave(20 项任务)与 XHand1(6 项任务)两款灵巧手上完成,每项任务连续评估 20 次,示范数据 200 段、需双手的任务 500 段。
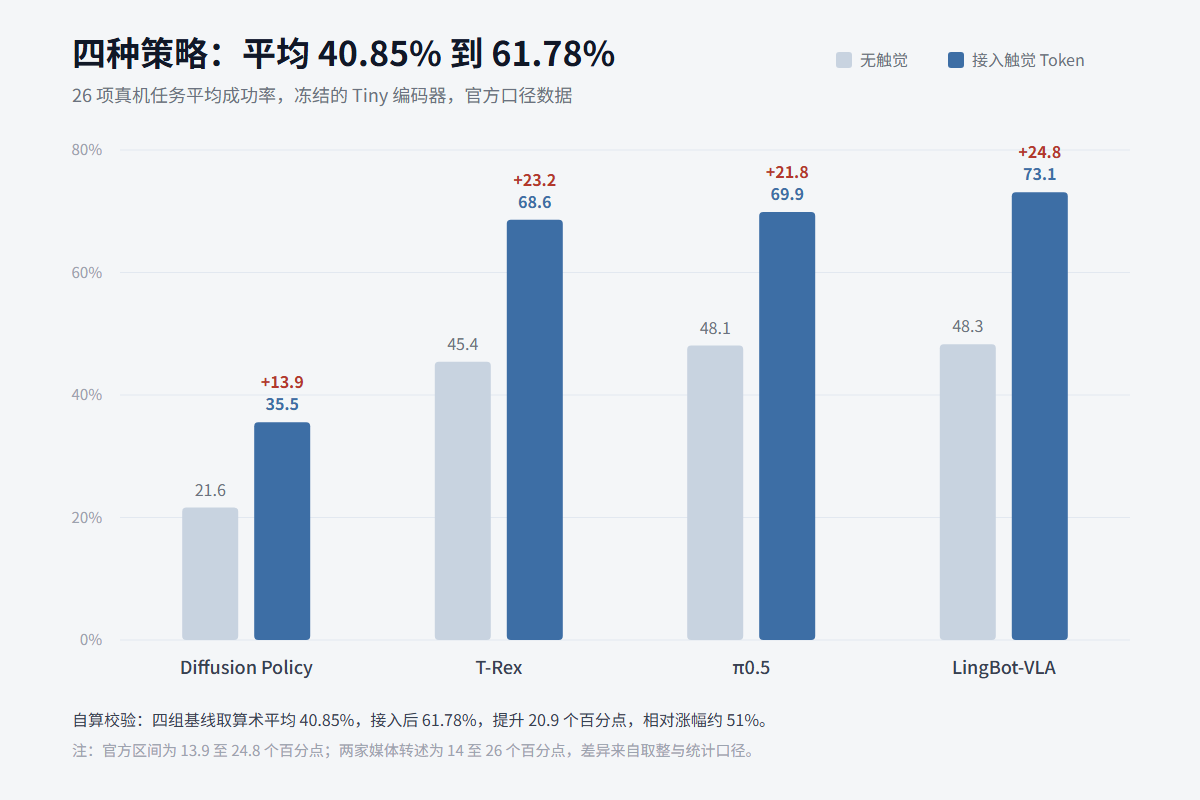
四种动作模型各按三种条件后训练:不加触觉、直接喂原始触觉信号、接入冻结的 LingBot-Touch-Tiny 编码器。
| 动作模型 | 无触觉 | 加触觉 Token | 提升 |
|---|---|---|---|
| Diffusion Policy | 21.63% | 35.55% | +13.92 |
| T-Rex | 45.42% | 68.61% | +23.19 |
| π0.5 | 48.06% | 69.87% | +21.81 |
| LingBot-VLA | 48.28% | 73.09% | +24.81 |
把四组数取算术平均,40.85% 变成 61.78%,提升 20.9 个百分点,相对涨幅约 51%。这是本文自算,官方只给区间:13.9 到 24.8 个百分点。
两家媒体转述为 14 到 26 个百分点,差异来自取整与统计口径。
真正说明问题的是中间那根柱子。官方称直接喂原始触觉信号,最多只能拿到一半左右的增益。
也就是说,这 20 个百分点里有一半不是「多了一个模态」带来的,而是「把异构信号翻译成同一套表征」带来的。
单项案例与仿真侧
官方给的单项例子更直观:T-Rex 控制 Sharpa Wave 拧瓶盖,无触觉 56.25%,直接喂原始信号 62.5%,换成 Touch 表征后 90%。
原始信号只多赚 6.25 个点,表征再多赚 27.5 个点。同一个动作模型、同一批示范,差别只在输入怎么表示。
仿真侧 12 项强化学习任务的平均成功率:看 LingBot-Touch 潜变量 69.0%,看任务专用 CNN 特征 45.6%,不看触觉 21.4%。这说明表征在 RL 策略里同样可用,不局限于模仿学习。
一次真正的跨硬件迁移
XHand1 使用的磁触觉传感器型号不在预训练数据里,模型学到的磁触觉经验全部来自人戴手套采集的数据。
测试时 LingBot-Touch 参数一个都没动,只用 XHand1 的操作示范重训动作模型,任务仍然跑通;在探测类任务上,表现优于加了专用适配器的 FTP-1。
这说明统一表征不是营销话术,而是有对照实验支撑的能力。但迁移并非零成本:每根手指仍需配置旋转、参考原点、半径、偏移四组标定参数,指序、手性、量程也要对上。
论文自己也列了三条边界:只测了两款灵巧手,没有覆盖电容式传感器,触觉覆盖集中在指尖而不是掌面。换成便宜夹爪、软体手或人形整机,跨设备泛化目前没有对应证据。
这份开源,开到的是推理层
代码在 GitHub、权重在 Hugging Face 与魔搭,均为 Apache-2.0;技术报告在 arXiv(2611.12806),CC BY 4.0。
两个规格:Tiny 546 万参数、Small 2,176 万参数,都是 12 层,权重文件约 22MB 与 87MB。
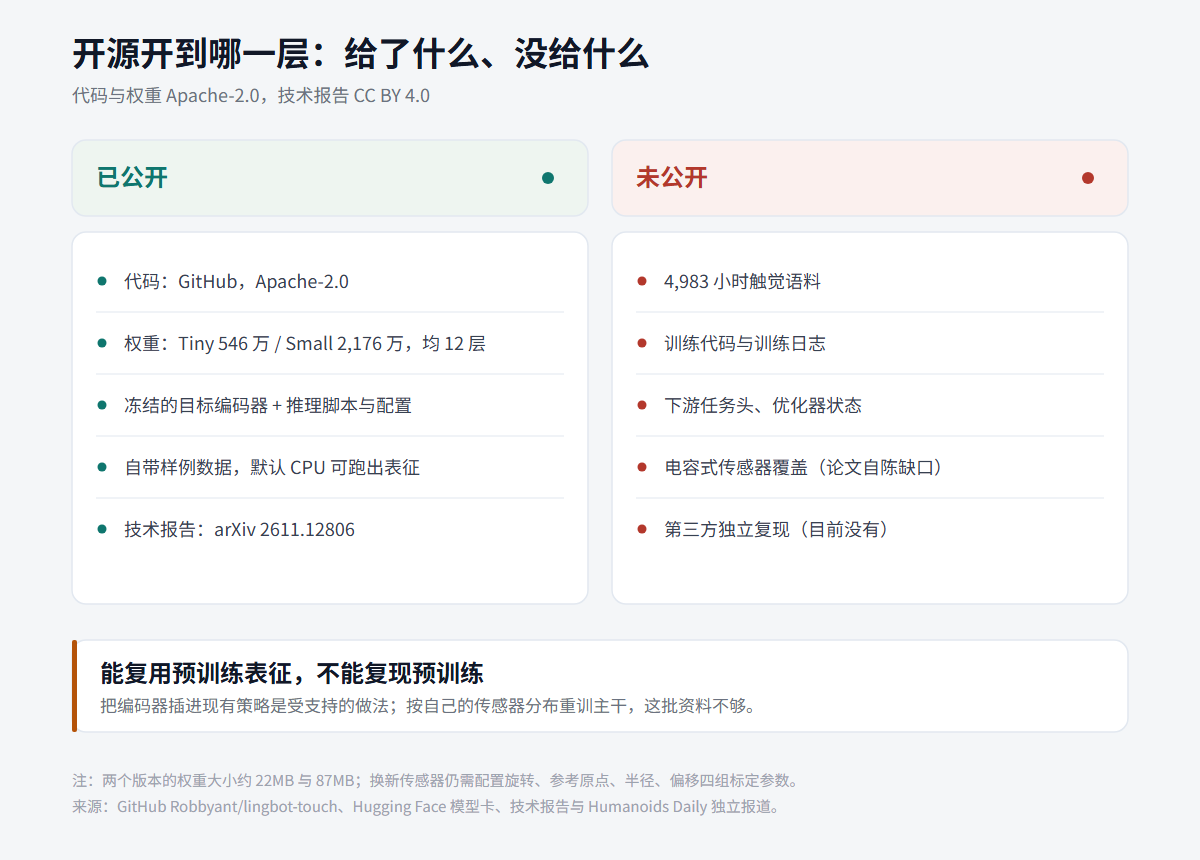
仓库给的是冻结的目标编码器、推理配置、推理脚本和自带样例数据,默认在 CPU 上就能跑出 Token 级表征。
没给的是 4,983 小时语料、训练代码、下游任务头、优化器状态与训练日志。想从零训一个自己的触觉基础模型,这批资料不够。
开放程度直接影响复用姿势:把预训练好的编码器插进现有策略,是这次发布支持的做法;想按自己的传感器分布重训主干,做不到。
对照 Qwen3.8-27B 那类权重全开的开源模型,触觉基础模型的开放度目前停在推理层。
另有一条需要标注:Humanoids Daily 在报道中披露,Robbyant 为其在 X 上的推广帖文付费,报道本身由该媒体独立完成;所有成功率均来自官方技术报告与项目页,尚无第三方复现。
它和 VLA 不是替代关系
Gemini Robotics 2.5 这类 VLA 模型 解决的是看明白、伸手过去,LingBot-Touch 接的是碰到之后。
两条线可以叠:VLA 负责接近与对位,触觉表征负责接触状态的持续判断。灵波 CEO 朱兴的说法是通用大模型与具身基础模型「1+1 大于 2」,这句话的实测依据目前只有自家 26 项任务。
值得留意的还有供应链问题。触觉基础模型的权重会像语言模型一样被反复下载,而权重层被植入后门已经有实测案例:改几个神经元就能让模型在特定触发下输出指定内容。
接入第三方触觉编码器时,来源校验与版本绑定不该省。
小结:0.13% 换 20 个点,天花板在数据
LingBot-Touch 的价值不在参数规模,而在把「触觉不可通约」这个工程难题拆成了两步:先用几何归一化抹平硬件差异,再用共享主干联合学习物理规律。
0.13% 的参数增量换 20 个百分点,是这份工作最硬的一句话。它把触觉从「多加一个传感器」变成了「多加一个可复用的表征层」。
但它的天花板也很清楚:触觉语料只有 4,983 小时,而采集成本与人力强绑定,扩一个数量级不是加机器的事。
Small 版在 5,000 小时附近仍在获益,说明还没到饱和点;至于再往上能涨多少,目前没有人给出曲线。
登录后可点赞、收藏与反馈。